前言
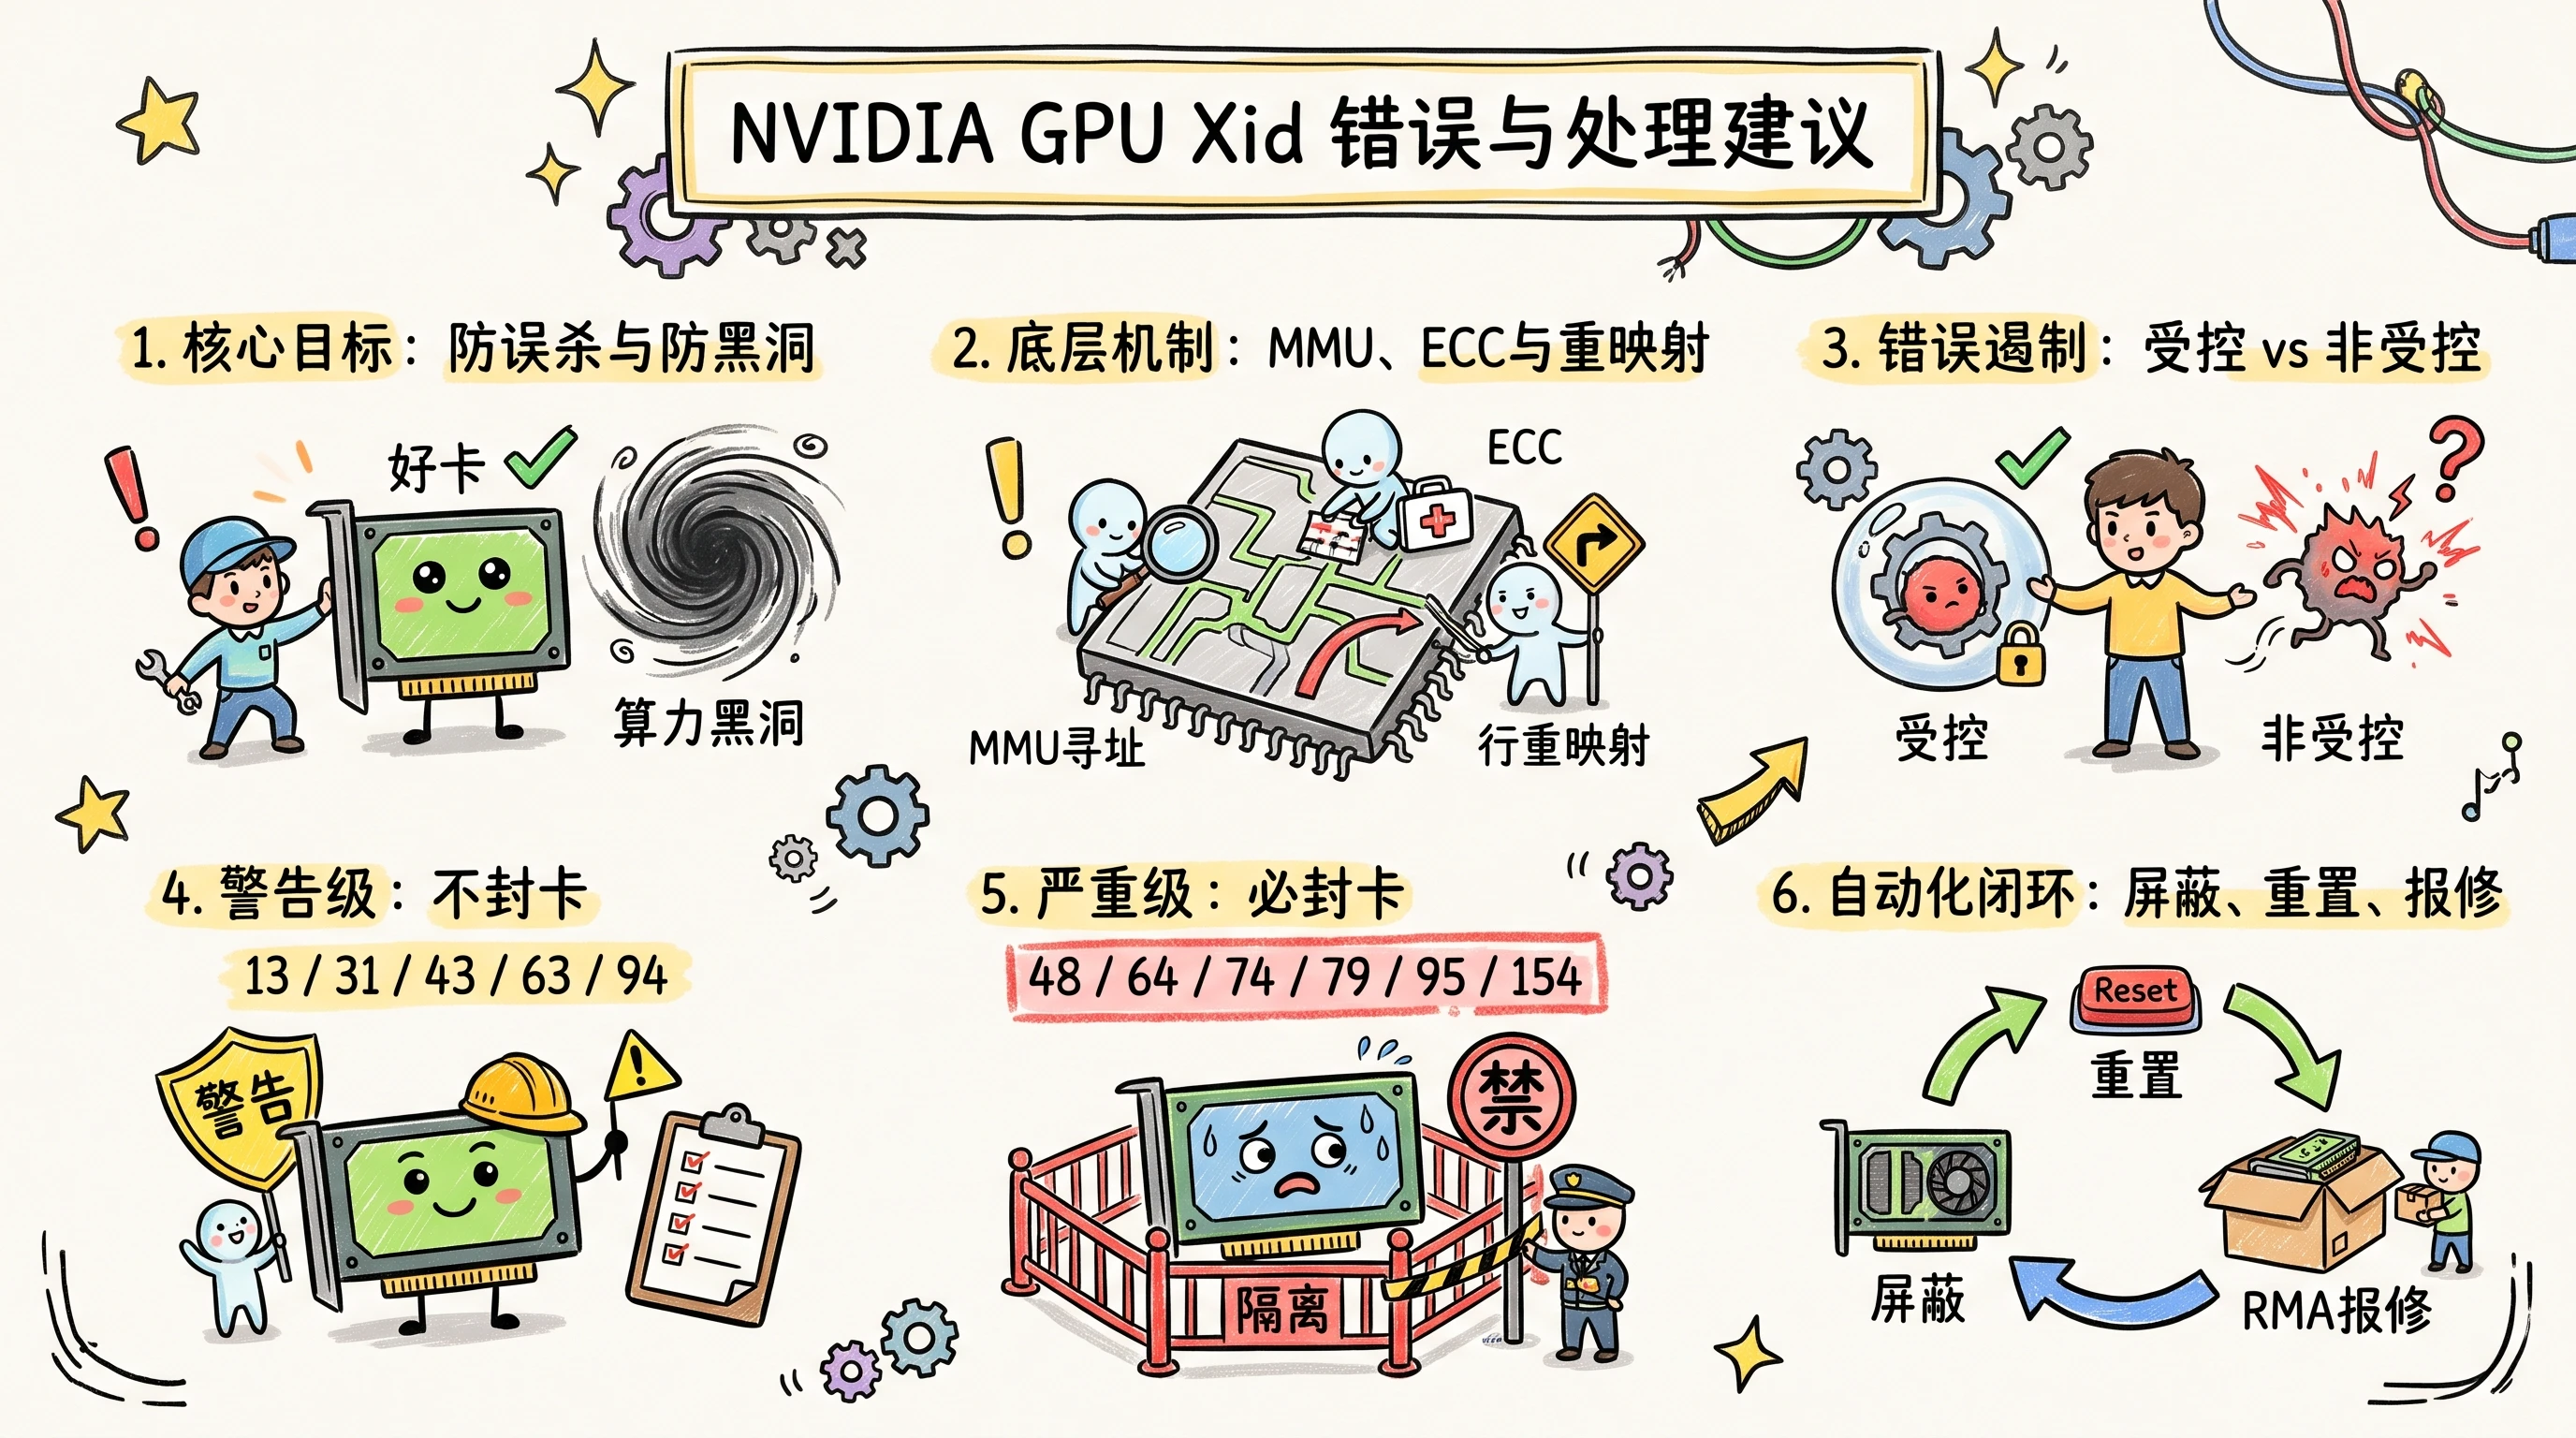
在大模型训练与高并发推理集群中,任务中断时最核心的排障问题是:究竟是业务代码存在越界与指针Bug,还是底层物理显卡发生了硬件损坏?
- 过度反应(误杀好卡):将业务代码越界或硬件已自愈的轻微事件当作硬件损坏,盲目封禁节点(
Cordon/Taint)或重启服务器,导致同机健康任务被中断。 - 响应不足(算力黑洞):当
GPU发生不可纠正的显存损坏、NVLink断链或PCIe掉卡时未及时屏蔽。由于坏卡上的任务会立即报错退出并释放资源,调度器会误判该卡“空闲”并持续把新作业调度上去,短时间内吞噬大量任务。
Xid(Xid Error Messages)是NVIDIA内核驱动(NVRM)在检测到硬件、固件或应用异常时向系统内核日志打印的标准诊断代码,同一Xid编号在不同驱动版本中含义保持一致。通过以下命令即可在宿主机检索Xid日志:
# 查看带时间戳的内核 Xid 日志(含 GPU PCI 地址与 UUID 映射前导行)
sudo dmesg -T | grep -iE "NVRM: GPU at|NVRM: Xid"
典型日志结构如下:
[Thu Oct 29 14:22:05 2026] NVRM: GPU at PCI:0000:65:00: GPU-1f027ee8-6e1e-2b8c-0108-3d370e5f0418
[Thu Oct 29 14:22:05 2026] NVRM: Xid (PCI:0000:65:00): 94, pid=7062, name=python3, Contained: CE User Channel (0x9). RST: No, D-RST: No
其中PCI:0000:65:00为物理插槽总线地址,GPU-1f027ee8-...为跨重启不变的显卡UUID,冒号后的94即为Xid编号,pid标识触发进程,RST: Yes/No与D-RST: Yes/No指示是否需要立即重置GPU或排空作业后重置。若需向厂商报修,可执行sudo nvidia-bug-report.sh(掉卡卡死时加--safe-mode --extra-system-data)收集诊断包。
NVIDIA官方Xid手册地址:https://docs.nvidia.com/deploy/xid-errors/index.html
核心前置概念速览
在查阅具体Xid编号前,先理解以下几个高频出现的硬件与驱动底层概念,有助于明白各个Xid的触发原理与恢复要求:
| 核心概念 | 通俗类比 | 技术原理与关联Xid |
|---|---|---|
Channel与GR引擎 | 业务窗口与计算车间 | 驱动为每个GPU上下文分配独立的硬件通道(Channel),将算子交由GR计算引擎(含SM流式多处理器)执行。代码算子越界会报Xid 13;进程崩溃导致通道被驱动强制回收会报Xid 43。 |
MMU(内存管理单元) | 显存地址翻译官 | 负责将程序中的虚拟显存地址翻译为HBM物理显存地址。若程序访问空指针、越界地址或已释放显存,MMU会触发缺页异常(Xid 31,相当于CPU的段错误SIGSEGV)。 |
ECC(SBE与DBE) | 显存纠错码 | 单比特翻转(SBE) 由硬件自动纠错,业务无感;双比特或多比特翻转(DBE) 硬件无法自动修复,称为不可纠正错误(UCE),会触发Xid 48、94或95。 |
InfoROM | 板载非易失病历本 | GPU板卡上的持久只读存储器,断电不丢失,用于存储设备UUID、历史ECC统计及显存坏块隔离记录。 |
| 页面退役与行重映射 | 显存坏块隔离机制 | V100及更早架构采用动态页面退役(Page Retirement)(软件层屏蔽坏页,上限64页);A100/H100/B100等采用硬件行重映射(Row Remapping)(每个显存Bank预留硬件备用行,在GPU Reset时透明替换坏行,整卡上限512行)。记录写入InfoROM成功报Xid 63,写入失败或备用行耗尽报Xid 64。 |
| 动态页面下线 | 在线实时软隔离 | Ampere(A100)起引入。发生显存错误时,驱动立即在软件层将坏页标记为不可用(Dynamic Page Offlining),无需立刻重置GPU,新老任务均不会再分配到该坏页。 |
| 错误遏制机制 | 故障防扩散隔离舱 | Ampere(A100)起引入(Error Containment)。当发生不可纠正ECC错误时,若硬件成功将损坏限制在触发错误的单个进程内,报受控错误Xid 94(同卡其他任务不受影响);若错误扩散至共享缓存/全局结构无法隔离,则报非受控错误Xid 95(必须重置整张GPU)。 |
从Ampere架构开始,显存发生不可纠正ECC错误时的硬件自愈与Xid触发关系如下:
常见Xid分级总览与处置决策
围绕生产环境中最常见的11个Xid代码,我们根据“故障是否破坏GPU全局可用性”将其划分为两大阵营:
- 警告类
Xid(通常无需屏蔽GPU卡):13、31、43、63、94。此类错误源于用户代码缺陷(13、31、43),或硬件已完成在线坏块隔离与记录(63、94),GPU依然具备正常服务能力,切忌盲目封卡。 - 严重错误类
Xid(必须立即屏蔽GPU卡):48、64、74、79、95、154。此类错误意味着显存发生不可遏制损坏、重映射失效、NVLink断链、PCIe掉卡或驱动强制要求重置/重启,必须立即将该GPU卡(或所在节点)从调度池屏蔽。
警告类Xid详解与处理建议(13、31、43、63、94)
以下Xid在生产集群中通常作为警告事件处理,无需立即屏蔽GPU卡。各错误码的官方定义、触发原理、实际案例与处理建议汇总如下表:
Xid | 官方名称与触发机制 | 实际案例与典型日志特征 | 官方处理建议与排障要点 |
|---|---|---|---|
13 | Graphics Engine Exception(图形/计算引擎异常) SM计算单元在执行CUDA Kernel时遇到数组越界读写(Out Of Range Address)、非法指令(Illegal Instruction)、地址未对齐或非法寄存器访问。 | 案例:自定义Triton/CUDA算子在特定Batch下数组下标越界,训练抛出illegal memory access并退出。日志特征:含 Graphics SM Warp Exception on (GPC x, TPC y, SM z)。 | 官方动作:RESTART_APP1. 不屏蔽卡,驱动会自动回收崩溃进程上下文。 2. 使用 compute-sanitizer --tool memcheck或设置CUDA_DEVICE_WAITS_ON_EXCEPTION=1配合cuda-gdb定位越界代码行。3. 仅当同一物理卡在运行不同正常作业时始终在同一 GPC/TPC/SM报错,才需运行dcgmi diag -r 3排查硬件。 |
31 | GPU Memory Page Fault( GPU显存缺页中断)相当于 GPU上的段错误(SIGSEGV)。计算或拷贝单元访问了未映射的虚拟地址、空指针或已提前释放的显存,被MMU硬件拦截。 | 案例:推理服务开启CUDA Graph后,图内引用的临时张量被提前释放,重放时触发缺页中断。日志特征:含 MMU Fault: ENGINE ... faulted @ 0x... FAULT_PDE ACCESS_TYPE_VIRT_READ。 | 官方动作:RESTART_APP1. 不屏蔽卡, MMU拦截后GPU本身完全健康。2. 重跑任务若“跟任务走”,属代码指针或显存生命周期 Bug,用compute-sanitizer排查。3. 仅当同一 UUID显卡跨不同作业高频复现Xid 31时,才排查显存硬件。 |
43 | GPU Stopped Processing(通道重置校验错误) 用户程序因软件异常、核函数死锁超时或被外部信号(如 SIGKILL/Ctrl-C)强杀,驱动强制终止并回收其Channel。官方文档明确指出此时GPU保持健康。 | 案例:分布式训练中某Rank因数据加载卡死被框架看门狗超时Kill,内核打印Xid 43并伴随清理事件Xid 45。日志特征:含 pid=xxx, name=python3, Ch 00000010。 | 官方动作:IGNORE1. 严禁因此屏蔽卡,这只是软件异常退出后的正常通道清理动作(常与 Xid 45成对出现)。2. 检查 Xid 43前序日志是否有其他核心Xid、宿主机OOM Killer记录或业务侧死锁超时日志。 |
63 | Row Remapping / Page Retirement Event(显存行重映射/页退役记录成功) 发生 ECC错误后,驱动成功将待退役页(V100及以前)或待重映射行(A100及以后)写入板载InfoROM。 | 案例:A800节点因单比特ECC累积或伴随Xid 94触发行重映射登记,业务容器正常运行。日志特征:含 Row Remapper: New row marked for remapping, reset gpu to activate。 | 官方动作:IGNORE1. 无需立即屏蔽卡, Xid 63代表硬件自愈记录成功,且坏页已被动态下线隔离。2. 若单独出现或伴随 Xid 94出现,存量任务继续运行,只需在**维护窗口择机执行nvidia-smi -r重置GPU**激活硬件重映射。3. 若紧跟在严重错误 Xid 48/95后出现,则按48/95流程排空重置。 |
94 | Contained Memory Error(受控的显存 ECC错误)适用 A100/H100/B100等架构。发生不可纠正ECC错误,但硬件错误遏制机制成功将其限制在单个进程内,并通过动态页面下线隔离了坏页。 | 案例:一张运行多个推理容器的A100偶发宇宙射线导致ECC翻转,仅1个容器报错退出,其余容器无损运行。日志特征:含 Contained: ... RST: No, D-RST: No(无需立即重置)。 | 官方动作:RESTART_APP1. 单次偶发无需屏蔽整卡,仅重启报错的单个进程/容器,同卡其他任务不受影响,择机在维护窗口重置 GPU。2. 注意在 k8s-device-plugin中将94与63加入忽略列表以防误封卡。3. 若同一张卡短时间内高频触发 Xid 94,说明显存颗粒持续劣化,需转入屏蔽报修。 |
警告类Xid常用排查命令
针对Xid 13/31的代码排查与Xid 63/94的重映射状态检查,常用命令如下:
# 1. 针对 Xid 13 / 31:使用官方 Compute Sanitizer 定位算子越界或非法指针的具体代码行
compute-sanitizer --tool memcheck python3 train.py

# 2. 针对 Xid 63 / 94:查看显存行重映射计数、待生效状态(Pending)与失败标志(Failure)
nvidia-smi -q -d ROW_REMAPER
严重错误类Xid详解与处理建议(48、64、74、79、95、154)
当检测到以下6类严重Xid时,表明GPU硬件、互联链路或全局上下文已处于不可用状态,必须第一时间屏蔽故障GPU卡(或隔离节点),禁止新任务调度。详细机制、案例与处置建议如下表所示:
Xid | 官方名称与为什么必须屏蔽GPU卡 | 实际案例与典型日志特征 | 官方恢复流程与RMA报修判定标准 |
|---|---|---|---|
48 | Double Bit ECC Error (DBE)(双比特不可纠正 ECC错误)显存( DRAM,新驱动伴随Xid 171)或片上缓存(SRAM/L2,新驱动伴随Xid 172)发生硬件无法修复的多比特错误。未重置前继续调度会导致任务立即崩溃或计算出错。 | 案例:大模型训练突然中断并抛出cudaErrorECCUncorrectable,内核报Xid 48。日志特征:含 An uncorrectable double bit error (DBE) has been detected on GPU。 | 官方动作:WORKFLOW_XID_48(排空并重置)1. 立即屏蔽该卡,排空同节点任务后执行 sudo nvidia-smi -i <id> -r重置GPU或重启节点。2. 执行 nvidia-smi -q -d ECC检查:若发生在SRAM且触发SRAM Threshold Exceeded标志(同一Bank超过2次SECDED或4次Parity不可纠正错误),或重置后仍复现Xid 48,直接下线运行Field Diagnostics并申请RMA换卡。 |
64 | Row Remapping / Page Retirement Failure(显存行重映射/页退役记录失败) 驱动尝试向 InfoROM记录坏块失败,或硬件备用行已耗尽。此时**GPU已彻底丧失隔离坏显存的自愈能力**,坏块直接暴露给应用。 | 案例:某老旧A100多次出现显存错误后报Xid 64,同时监控指标DCGM_FI_DEV_ROW_REMAP_FAILURE变为1。日志特征:含 Row Remapper: Failed to record row remapping event to infoROM。 | 官方动作:RESET_GPU与CONTACT_SUPPORT1. 立即屏蔽该卡并尝试重置 GPU/重启节点。2. 官方 DRAM RMA标准:单Bank已重映射满8行后再出错、已重映射行二次出错、整卡累计重映射达到**512行上限**,均会置位Row Remapper Failure : Yes。一旦置位或重启后仍报Xid 64,直接下线走RMA换卡。 |
74 | NVLink Error( NVLink高速互联错误)GPU间或与NVSwitch间的高速链路发生物理错误、子链路断开或校验超限(Blackwell架构细化为Xid 144~150)。在完成重置或重启前链路无法恢复,会导致多卡NCCL通信直接卡死。 | 案例:8卡H800训练中断,多张卡同时报Xid 74。排查发现是GPU 0先发生Xid 79掉卡,导致与之互联的对端卡被动报Xid 74。日志特征:含 NVLink: fatal error detected on link x(0x..., ...)。 | 官方动作:WORKFLOW_NVLINK_ERR1. 立即屏蔽相关卡/节点。 2. 先查“连坐效应”( Sympathetic Error):按时间戳对比整机Xid与Fabric Manager的SXid日志,若因对端掉卡引发,优先处理源头卡。3. 用 nvidia-smi nvlink -s/-e查链路状态,看日志首寄存器:Bit 4/5置位(ECC/Parity故障)在同一链路超2次则报修;Bit 8,9,12,16,17,21,22,24,28置位则检查SXM底座或线缆连接。4. 重启 Fabric Manager并重置GPU(或重启整机),用nccl-tests验证。 |
79 | GPU has fallen off the bus( GPU从PCIe总线上脱落/掉卡)驱动通过 PCIe总线访问GPU时完全无响应。此时nvidia-smi报错失联且软重置无效,任何分配上去的容器都会初始化失败。 | 案例:满载训练瞬态功耗飙升或散热不良,导致显卡触发保护从PCIe总线掉线,8卡节点变成7卡。日志特征:含 GPU has fallen off the bus。 | 官方动作:RESTART_BM(物理机重启)1. 立即屏蔽整台节点。 2. 通过`dmesg |
95 | Uncontained Memory Error(非受控的显存 ECC错误)发生不可纠正 ECC错误且波及二级缓存标签(LTC TAG)等跨进程共享结构,硬件错误遏制失败。在重置GPU前,任何新CUDA应用均无法启动。 | 案例:A100节点日志打印Xid 95,卡上所有容器同时崩溃,后续新调度上去的Pod全部报错退出。日志特征:含 Uncontained: LTC TAG ... RST: Yes, D-RST: No(强制要求重置)。 | 官方动作:RESET_GPU1. 立即屏蔽该卡。 2. 若开启了 MIG,先排空该物理卡上其余MIG实例的任务再执行GPU Reset;若未开启MIG,立即清理残留进程执行sudo nvidia-smi -i <id> -r重置或重启节点。3. 重置后检查 Row Remapper Failure与SRAM阈值,频繁复现则申请RMA。 |
154 | GPU Recovery Action Changed( GPU恢复动作状态变更)CUDA 12.7/R565+引入的汇总型元错误码,伴随其他底层严重Xid(如48,64,74,79,95等)出现,直接给出驱动要求系统执行的恢复动作级别。 | 案例:发生Xid 79或Xid 95后,紧接着打印一条Xid 154指明恢复动作。日志特征:含 GPU recovery action changed from 0x0 (None) to 0x2 (Node Reboot Required)。 | 官方动作:严格遵循Xid 154指示的状态码1. 只要目标状态从 0x0 (None)变为非零状态(0x1~0x4),必须立即屏蔽该GPU卡。2. 回溯紧邻的前一条原始 Xid定位根因,并按下方状态表执行重置或重启。 |
Xid 154的五种标准恢复动作状态表
当捕获到Xid 154时,可根据日志中的目标状态值(对应NVML的nvmlDeviceGetGpuRecoveryAction)直接执行自动化处置:
| 状态值与名称 | 是否屏蔽卡 | 状态含义与生产执行动作 |
|---|---|---|
0x0 (None) | 否 | 无需恢复操作,GPU处于健康可用状态,可正常接收新进程。 |
0x1 (GPU Reset Required) | 是 | 立即屏蔽该卡,终止卡上所有进程,执行sudo nvidia-smi -i <id> -r重置后方可重新启用。 |
0x2 (Node Reboot Required) | 是 | 立即屏蔽整台节点,故障已导致系统或总线状态不一致,排空任务后重启物理节点(必要时断电冷重启)。 |
0x3 (Drain P2P) | 是 | 立即屏蔽该卡,终止所有使用P2P点对点通信的进程并关闭UVM持久模式,随后再次查询下一步恢复状态。 |
0x4 (Drain and Reset) | 是 | 立即屏蔽新任务调度,允许卡上未受影响的存量任务继续运行至结束或Checkpoint,全部排空后执行nvidia-smi -r。 |
故障GPU卡屏蔽与集群自动化实践
明确了13, 31, 43, 63, 94仅需告警、48, 64, 74, 79, 95, 154必须屏蔽卡的分级原则后,可在单机环境与Kubernetes集群中按以下方式落地执行。
单机与裸金属环境下的重置与屏蔽操作
在裸金属服务器上处置严重Xid时,可通过以下命令完成单卡重置或强制屏蔽:
# 1. 尝试软重置故障卡(以 GPU 3 为例,重置前需确保无进程占用 /dev/nvidia3)
sudo fuser -k -9 /dev/nvidia3
sudo nvidia-smi -i 3 -r

# 2. 驱动级强制屏蔽:若坏卡无法立即更换,将其计算模式设为 PROHIBITED(禁止任何进程创建 CUDA 上下文)
sudo nvidia-smi -i 3 -c PROHIBITED
# 待日后硬件修复后恢复默认模式:sudo nvidia-smi -i 3 -c DEFAULT

# 3. 业务级环境变量屏蔽:使用健康卡的 UUID 列表(避免掉卡后数字索引偏移)
export CUDA_VISIBLE_DEVICES=GPU-1f027ee8-6e1e-2b8c-0108-3d370e5f0418,GPU-9e5b8fec-61bf-5124-a0a9-079af1b65cc6
注意:在配备
NVSwitch的Ampere架构(如DGX/HGX A100)裸金属节点上,必须确保nvidia-fabricmanager服务处于运行状态,才能使用nvidia-smi -i <id> -r单独重置单张GPU;而在Hopper(H100/H800)及更新架构上,无论Fabric Manager状态如何均支持单卡独立重置。
Kubernetes集群下的单卡自动屏蔽与告警配置
配置NVIDIA k8s-device-plugin精准屏蔽严重Xid
NVIDIA k8s-device-plugin通过NVML监听Xid事件,一旦捕获未忽略的Xid,会自动将该卡标记为Unhealthy并上报Kubelet,将其从节点可分配容量(Allocatable)中扣除。
但其源码(internal/rm/health.go)默认仅忽略了13, 31, 43, 45, 68, 109,默认未忽略63和94,容易导致A100/H100偶发受控错误时被误封整卡。生产环境可通过环境变量DP_DISABLE_HEALTHCHECKS与DP_ENABLE_HEALTHCHECKS调整:
# 方式一:在内置忽略列表(13,31,43,45,68,109)基础上,追加忽略 63 和 94(推荐)
env:
  - name: DP_DISABLE_HEALTHCHECKS
    value: "63,94"

# 方式二:白名单模式,仅当出现指定的严重 Xid 时才将 GPU 标记为 Unhealthy 屏蔽
env:
  - name: DP_DISABLE_HEALTHCHECKS
    value: "xids"
  - name: DP_ENABLE_HEALTHCHECKS
    value: "48,64,74,79,95,154"
当故障卡完成nvidia-smi -r重置并通过dcgmi diag -r 2验证后,删除该节点上的nvidia-device-plugin实例Pod使其重建,即可解除Unhealthy屏蔽状态。对于多机8卡分布式训练场景,还可配合Node Problem Detector (NPD)监听/dev/kmsg中的48|64|74|79|95|154正则,直接对整机节点执行Cordon隔离。
配置DCGM-Exporter与Prometheus分级告警规则
基于DCGM Exporter采集的DCGM_FI_DEV_XID_ERRORS与DCGM_FI_DEV_ROW_REMAP_FAILURE指标,在Prometheus中配置区分警告级与严重屏蔽级的告警规则(注意DCGM_FI_DEV_XID_ERRORS仅保留最近一次Xid值,生产环境建议同时采集宿主机dmesg日志以防连续报错被覆盖):
groups:
  - name: gpu-xid-tiered-alerts
    rules:
      # 1. 警告类 Xid (13, 31, 43, 63, 94):无需立即屏蔽 GPU 卡
      - alert: GPUXidWarningEvent
        expr: DCGM_FI_DEV_XID_ERRORS == 13 or DCGM_FI_DEV_XID_ERRORS == 31 or DCGM_FI_DEV_XID_ERRORS == 43 or DCGM_FI_DEV_XID_ERRORS == 63 or DCGM_FI_DEV_XID_ERRORS == 94
        for: 0m
        labels:
          severity: warning
        annotations:
          summary: "节点 {{ $labels.hostname }} GPU {{ $labels.gpu }} 触发警告类 Xid ({{ $value }})"
          description: "GPU UUID={{ $labels.UUID }} 报告警告级 Xid {{ $value }}。若为 13/31/43 请排查业务 Pod ({{ $labels.exported_pod }}) 代码;若为 63/94 说明硬件已动态隔离坏页,建议在维护窗口重置 GPU。"

      # 2. 严重错误类 Xid (48, 64, 74, 79, 95, 154) 及行重映射失败:必须立即屏蔽 GPU 卡
      - alert: GPUXidCriticalIsolationRequired
        expr: DCGM_FI_DEV_XID_ERRORS == 48 or DCGM_FI_DEV_XID_ERRORS == 64 or DCGM_FI_DEV_XID_ERRORS == 74 or DCGM_FI_DEV_XID_ERRORS == 79 or DCGM_FI_DEV_XID_ERRORS == 95 or DCGM_FI_DEV_XID_ERRORS == 154 or DCGM_FI_DEV_ROW_REMAP_FAILURE > 0
        for: 0m
        labels:
          severity: critical
        annotations:
          summary: "节点 {{ $labels.hostname }} GPU {{ $labels.gpu }} 触发致命异常,必须立即屏蔽!"
          description: "GPU UUID={{ $labels.UUID }} 触发严重错误(Xid={{ $value }}),请立即确认该卡已标记为 Unhealthy 或节点已 Cordon,并结合 dmesg 执行重置、冷重启或 RMA 报修。"