前言
在大规模人工智能训练、分离式推理以及高性能计算(HPC)场景中,RDMA(Remote Direct Memory Access,远程直接内存访问)凭借内核旁路(Kernel Bypass)、零拷贝(Zero Copy)与处理器卸载(CPU Offload)三大核心特性,能够以微秒级超低延迟与数百Gbps的线速吞吐完成跨节点内存直通读写。无论底层物理网络采用原生的InfiniBand(简称IB)架构,还是采用基于无损以太网的RoCEv2架构,RDMA都已成为现代智算中心不可或缺的通信底座。
当基础设施处于传统的裸金属服务器或Slurm超算集群环境时,应用程序(例如基于PyTorch与NCCL的大模型分布式训练,或基于vLLM、Mooncake的分离式推理KV Cache传输)可以直接访问宿主机上的物理RDMA网卡、设备文件以及所有网络接口,配置过程相对直观。然而,当我们将这些算力节点纳管进以Kubernetes为核心的云原生集群,并把训练或推理任务封装进一个个受隔离的Pod容器内时,许多工程团队会遇到一个极其典型的困境:明明宿主机上插着昂贵的400Gbps ConnectX-7高速网卡,但Pod内的NCCL通信库却找不到RDMA设备,或者在内存注册阶段报错退出,甚至悄无声息地回退(Fallback)到了慢上十倍的普通TCP/IP Socket以太网通信。
为什么在裸金属上能够直接运行的RDMA应用,进入Kubernetes Pod后却步履维艰?这是因为RDMA所追求的 “极致硬件直通” 与云原生容器所奉行的 “严格命名空间与资源隔离” 之间存在着天然的架构冲突。在云原生集群下打通Pod间的RDMA通信,绝不仅仅是给容器挂载一个设备目录那么简单,而是需要跨越多层技术栈的协同配合。
为了彻底理清这套跨层级的技术栈并给出可落地的工程方案,下文将从底层通信机理出发,自底向上依次展开。
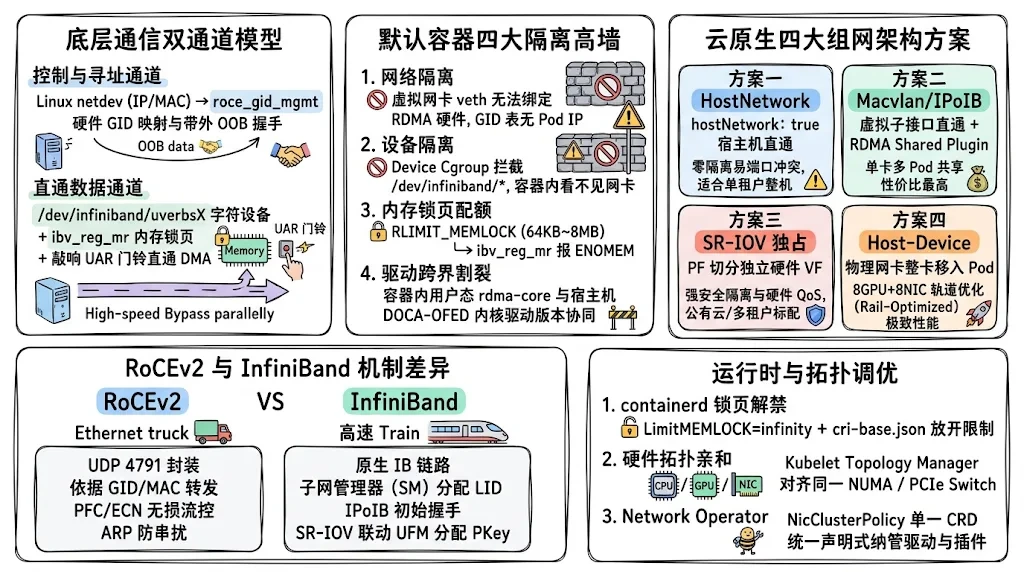
前置基石:Linux下RDMA的“双通道模型”与容器化困局
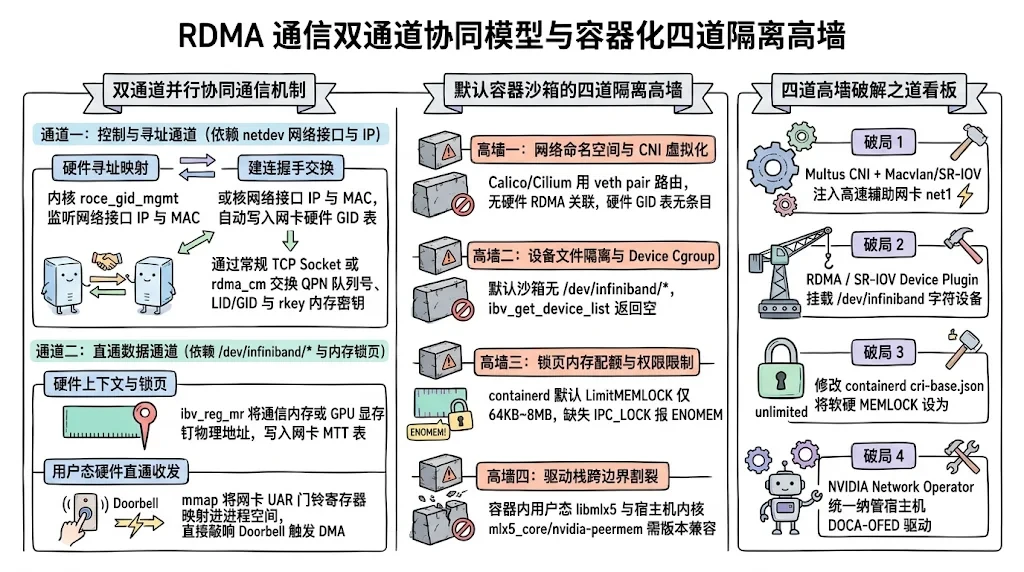
在接触Multus、SR-IOV或Device Plugin等云原生组件之前,我们需要先退一步思考一个最本质的问题:在普通的Linux操作系统上,两个进程究竟是如何建立并完成一次RDMA通信的?
一次RDMA通信的“双通道协同”原理
如果对Verbs接口、队列对、完成队列,以及InfiniBand、RoCE、iWARP的分层差异感兴趣,想再看细一些,可以查看我之前的文章:RDMA技术架构深度解析。
很多初学者容易产生一个误解:既然RDMA是“绕过操作系统内核(Kernel Bypass)”直接访问网卡硬件,那是不是完全不需要Linux系统的常规网络接口(如eth0或ib0)和IP地址了?
答案是否定的。RDMA绕过内核指的是数据传输阶段(数据面)不经过内核TCP/IP协议栈;但在通信开始前的寻址、建连与硬件填表阶段(控制面),它依然高度依赖Linux内核网络子系统与字符设备接口。具体而言,Linux下的标准RDMA通信(基于OpenFabrics Enterprise Distribution,即OFED协议栈)是由两条并行通道协同完成的:
如上图所示,这两条通道各自承担着不可替代的职责:
- 通道一:控制与寻址通道(依赖
Linux网络接口netdev与IP地址)- 建连握手(
OOB或rdma_cm):数据传输前,通信双方需先通过常规IP网络(带外TCP Socket或rdma_cm)交换各自的队列对编号(QPN)、端口寻址标识(LID/GID)及远端内存访问密钥(rkey)。 - 硬件
GID寻址表映射:在RoCEv2中,内核roce_gid_mgmt模块会实时监听RDMA设备(如mlx5_0)关联的网络接口(如ens1f0),将其IP与MAC地址编码为128位全局标识符(GID)写入网卡硬件GID表,供网卡硬件在内核旁路发送时直接封装UDP/IP报文头。
- 建连握手(
- 通道二:直通数据通道(依赖
/dev/infiniband/*字符设备与内存锁定)- 硬件上下文与内存锁页:用户态程序通过
libibverbs打开/dev/infiniband/uverbsX创建队列对(QP),并调用ibv_reg_mr()将通信内存或GPU显存钉死(Pin/Lock)在物理地址上,防止DMA期间发生内核换页(Swap),同时向网卡写入虚实地址映射表。 - 用户态硬件直通收发:内核驱动将网卡硬件门铃寄存器(
UAR)通过mmap直接映射到进程虚拟地址空间;应用发送数据时无需发起系统调用或陷入内核,直接写入工作请求并敲响门铃(Doorbell)即可触发硬件DMA收发。
- 硬件上下文与内存锁页:用户态程序通过
标准Kubernetes容器环境面临的四道隔离高墙
理解了上述“双通道模型”后,我们再来看当一个应用被放进标准的Kubernetes Pod中时,会发生什么。
为了保障多租户安全与资源隔离,Kubernetes与底层容器运行时(如containerd)默认使用Linux Namespace、Cgroups和Capabilities机制为每个Pod构建了一个严密的“沙箱”。在普通的微服务场景下,这套沙箱完美运作;但对于需要同时打通“控制寻址通道”与“直通数据通道”的RDMA应用而言,默认的容器沙箱恰恰竖起了四道高墙,将两条通道彻底截断:
我们可以逐一拆解这四道隔离高墙带来的具体阻碍:
| 隔离维度 | Kubernetes默认行为 | 对RDMA通信造成的核心阻碍 | 需要引入的云原生解决思路 |
|---|---|---|---|
高墙一:网络命名空间(NetNS)与CNI虚拟化 | Calico、Cilium等默认CNI插件通过纯软件虚拟的veth pair连接Pod与宿主机,数据包必须经过宿主机内核协议栈路由或Overlay隧道封装 | 虚拟网卡veth背后没有绑定任何RDMA硬件加速引擎;宿主机物理RDMA网卡的硬件GID表中也没有Pod的IP地址,导致通道一(寻址与GID映射)彻底失效 | 引入Multus CNI多网络平面,配合SR-IOV、Macvlan、IPoIB或Host-Device插件,将具备硬件RDMA关联能力的网络接口直接送入Pod NetNS |
高墙二:设备文件隔离与Device Cgroup拦截 | 容器运行时默认只向容器内挂载/dev/null、/dev/random等基础虚拟设备,Device Cgroup禁止非特权容器访问宿主机硬件设备节点 | 容器内根本不存在/dev/infiniband/uverbsX和/dev/infiniband/rdma_cm设备文件,ibv_get_device_list()返回空列表,导致通道二(直通数据通道)无法打开 | 引入Kubernetes Device Plugin(如RDMA Shared Device Plugin或SR-IOV Device Plugin)及CDI机制,按需将指定的/dev/infiniband/*安全挂载进容器 |
高墙三:锁页内存配额(MEMLOCK)与能力裁剪 | containerd默认将容器进程的RLIMIT_MEMLOCK(最大可锁定物理内存)限制为64KB或8MB,且默认剥夺CAP_IPC_LOCK内核特权能力 | RDMA注册数百MB至数十GB通信缓冲区或显存时,ibv_reg_mr()因无法锁定物理内存而直接报错ENOMEM(Cannot allocate memory) | 调整宿主机containerd的LimitMEMLOCK与base_runtime_spec基础运行时规范,并为容器按需配置IPC_LOCK安全上下文 |
高墙四:驱动栈跨容器边界分裂(Split Driver) | 容器仅打包用户态文件系统,共享宿主机Linux内核,不具备独立内核模块加载能力 | RDMA依赖容器内的用户态驱动库(libibverbs、libmlx5)与宿主机内核态驱动模块(mlx5_core、mlx5_ib、nvidia-peermem)直接通信,版本或接口不匹配将导致通信异常 | 通过NVIDIA Network Operator统一纳管宿主机DOCA-OFED内核驱动生命周期,并规范业务容器镜像内的rdma-core/MOFED用户态库版本 |
看清了这四道高墙,接下来我们解决问题的脉络就变得异常清晰:只要我们自底向上依次拆掉这四道阻碍——配齐内核驱动与命名空间模式、打通RDMA网络接口与设备文件挂载、理顺RoCE/IB协议寻址、放开容器运行时内存锁页限制,Pod之间的RDMA通信就能水到渠成。
驱动与内核底座:打通跨容器边界的软硬件协同
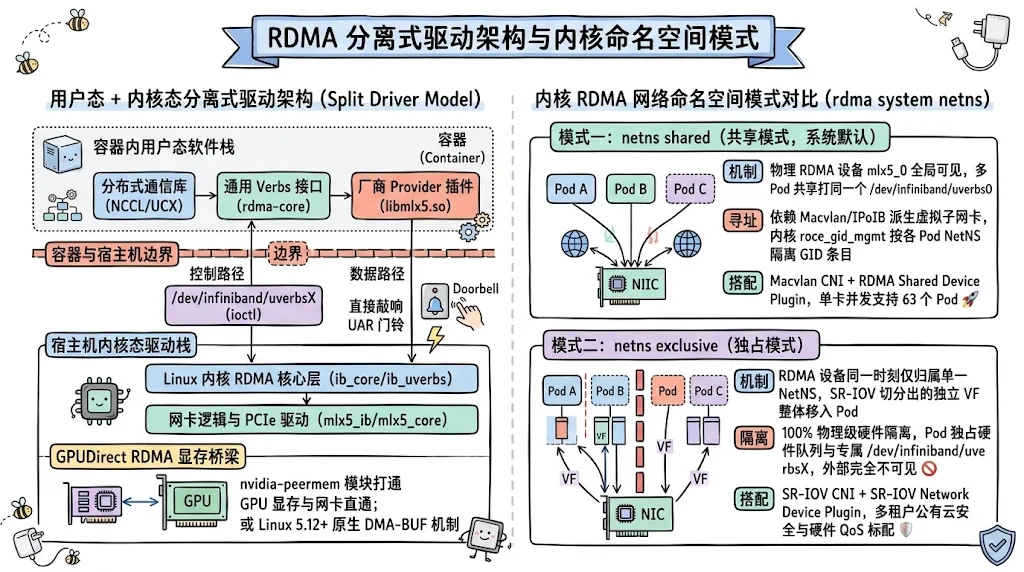
在动手配置Kubernetes网络插件之前,首先必须确保宿主机操作系统内核与容器镜像内部的驱动底座能够无缝咬合。如果底层驱动与内核模式没有配对,上层网络插件无论如何编排都无法生效。
RDMA“用户态+内核态”分离式驱动架构
为什么我们常说RDMA的驱动管理比普通以太网卡复杂得多?
普通TCP/IP网卡的数据包收发全部在操作系统内核中完成,容器里的应用程序只需要调用标准的POSIX Socket API(如send()、recv()),容器镜像里根本不需要安装任何网卡厂商的专用驱动。但RDMA为了实现“内核旁路(Kernel Bypass)”,让容器内的用户态进程能够直接操作网卡硬件上的队列寄存器(QP/CQ/Doorbell),就必须在容器用户态也植入一套了解网卡硬件寄存器布局的专用驱动库。
这就构成了RDMA标志性的分离式驱动架构(Split Driver Model):
在云原生环境下维护这套分离式驱动,需要重点把握以下三个工程原则:
- 用户态驱动库直接预装在容器镜像内,无需从宿主机挂载:
不同于
NVIDIA GPU需要将宿主机libcuda.so挂载进容器以严格对齐驱动版本,Linux内核RDMA子系统(ib_uverbs)在用户态rdma-core与内核驱动之间提供了向后兼容的稳定二进制接口(ABI)。因此,只需在业务镜像中预装用户态驱动库(如rdma-core、libibverbs1、ibverbs-providers、librdmacm1),运行时仅将/dev/infiniband/*字符设备挂载进容器即可。 - 宿主机内核驱动选型与容器化托管:
以主流的
NVIDIA ConnectX系列网卡为例,宿主机可使用高版本Linux内核自带的开源驱动(Inbox Driver),但生产集群通常推荐使用包含完整硬件卸载特性与nvidia-peermem模块的NVIDIA DOCA-OFED(原MLNX_OFED)驱动栈。在Kubernetes中,可通过NVIDIA Network Operator以特权驱动容器(ofedDriver DaemonSet)的形式自动完成节点驱动加载与版本管理。 - 宿主机必须加载的核心内核模块清单:
宿主机需确保以下内核模块已正常加载(可通过
lsmod | grep -E "mlx5|ib_|rdma"核查):
| 内核模块名称 | 所属层级 | 核心功能说明 |
|---|---|---|
mlx5_core/mlx5_ib | 厂商硬件驱动层 | NVIDIA ConnectX系列网卡的底层PCIe驱动与InfiniBand/RoCE核心逻辑驱动 |
ib_core | 内核RDMA核心层 | 提供RDMA设备注册、GID表管理(roce_gid_mgmt)及内核通用Verbs抽象 |
ib_uverbs | 用户态直通接口层 | 负责在/dev/infiniband/下生成uverbsX字符设备,处理容器内libibverbs的控制指令 |
rdma_cm/rdma_ucm | 连接管理层 | 提供与协议无关的RDMA建连管理,并暴露/dev/infiniband/rdma_cm供用户态调用 |
ib_umad | 子网管理报文层 | 暴露/dev/infiniband/umadX,供InfiniBand诊断工具与子网管理代理收发管理报文(MAD) |
ib_ipoib | IB网络适配层 | 在InfiniBand场景下提供IP over InfiniBand能力,将IB端口封装为标准网络接口(如ib0) |
nvidia_peermem | 异构显存直通层 | 打通NVIDIA GPU驱动与ib_core的PeerDirect接口,支撑传统模式的GPUDirect RDMA |
内核RDMA子系统的两种命名空间模式:shared与exclusive
当宿主机上跑起多个Pod时,Linux内核中的RDMA设备(如mlx5_0、mlx5_1)应该如何与各个Pod独立的 网络命名空间(Network Namespace,简称netns) 打交道?
自Linux Kernel 5.2起,内核RDMA子系统专门引入了网络命名空间隔离机制,允许通过iproute2工具包中的rdma命令查看和切换全局工作模式:
# 查看当前宿主机 RDMA 子系统的网络命名空间模式
rdma system show
# 输出示例:netns shared (默认值为 shared,可切换为 exclusive)
shared(共享模式) 与 exclusive(独占模式) 直接决定了上层Kubernetes网络插件与设备插件的架构选型,理解两者的底层差异至关重要:
两种模式的核心运行机制与对比如下表所示:
| 对比维度 | shared共享模式(rdma system set netns shared) | exclusive独占模式(rdma system set netns exclusive) |
|---|---|---|
| 底层可见性机制 | 所有的RDMA设备(mlx5_0等)在所有网络命名空间中全局可见。多个Pod可以同时打开同一个/dev/infiniband/uverbs0字符设备 | 每个RDMA设备在同一时刻只能存在于某一个特定的网络命名空间中。当把mlx5_2移入Pod A的netns后,宿主机和Pod B中将彻底看不到mlx5_2 |
多Pod寻址如何隔离 | 虽然共享mlx5_0,但每个Pod拥有独立的虚拟子接口(如Macvlan或IPoIB子接口)。内核roce_gid_mgmt在往mlx5_0硬件GID表写条目时,会记录该条目所属的Pod netns,确保Pod A只使用自己的IP/GID发包 | 每个Pod独占一个独立的RDMA设备(通常是SR-IOV切分出的VF虚拟网卡,或整张物理卡),各自拥有完全物理隔离的硬件GID表和硬件队列 |
| 匹配的云原生插件组合 | Macvlan CNI、IPVLAN CNI或IPoIB CNI配合 RDMA Shared Device Plugin | SR-IOV CNI、IB-SRIOV CNI或Host-Device CNI配合 SR-IOV Network Device Plugin |
| 核心优势与局限 | 优势:无需开启硬件SR-IOV,单张物理网卡即可供数十个Pod并发共享,部署极简。局限:共享同一个 uverbs字符设备,硬件级故障隔离与安全边界弱于独占模式 | 优势:最强安全性与硬件级QoS隔离,Pod内看到的设备视图与独占裸机完全一致。局限: Pod并发数受限于物理网卡或硬件VF数量;切换模式时要求当前无活跃自定义netns |
GPUDirect RDMA的内核桥梁:nvidia-peermem与DMA-BUF
在AI大模型集群中,单节点内(或多节点NVLink域内)的GPU间通信优先走带宽更高、延迟更低的NVLink/NVSwitch高速互联;而当跨节点Pod之间无法通过NVLink直连、必须借助RDMA网络通信时,核心优化目标是让RDMA网卡通过PCIe总线直接读写GPU显存(即 GPUDirect RDMA ,简称GDR),从而省去“显存↔宿主机内存”之间的两次多余拷贝。
如果对GPUDirect的数据路径、它和普通RDMA的差别,以及P2P、NVLink、NVSwitch各自解决哪一段通信感兴趣,想再看细一些,可以查看我之前的文章:GPU Direct通信技术。
要让容器内的通信库(如NCCL)在调用RDMA接口时能够直接注册GPU显存地址,宿主机内核必须提供一座连接NVIDIA GPU驱动与RDMA驱动的桥梁。目前业界存在两代并行的实现机制:
- 传统
PeerDirect桥接模块(nvidia-peermem): 目前生产环境最常用的方案。宿主机加载nvidia_peermem.ko模块后,会在内核RDMA核心层(ib_core)与NVIDIA GPU驱动之间建立桥接:当容器内的NCCL调用ibv_reg_mr()注册显存地址时,ib_core通过nvidia-peermem直接获取该显存对应的PCIe BAR1物理地址并写入网卡硬件映射表。 - 现代内核原生
DMA-BUF机制(Linux 5.12+、CUDA 11.7+): 无需依赖专有的nvidia-peermem桥接模块,但要求宿主机使用开源版GPU内核驱动(nvidia-open)。容器内的CUDA与NCCL将GPU显存导出为标准的Linux dma-buf文件描述符,直接通过ibv_reg_dmabuf_mr()交由内核标准接口完成跨设备PCIe P2P映射。
工程避坑提示:在
Kubernetes节点上,如果只打通了Pod间的普通主机内存RDMA,但宿主机未加载nvidia_peermem(或未启用开源GPU驱动的DMA-BUF支持),NCCL并不会报错停止,而是会悄悄回退到“先把数据从GPU显存经PCIe拷回宿主机CPU内存,再由RDMA网卡从CPU内存发出”的降级路径,导致跨机多卡通信带宽暴跌50%以上。
网络与设备插件层:云原生Pod间RDMA的四大主流架构
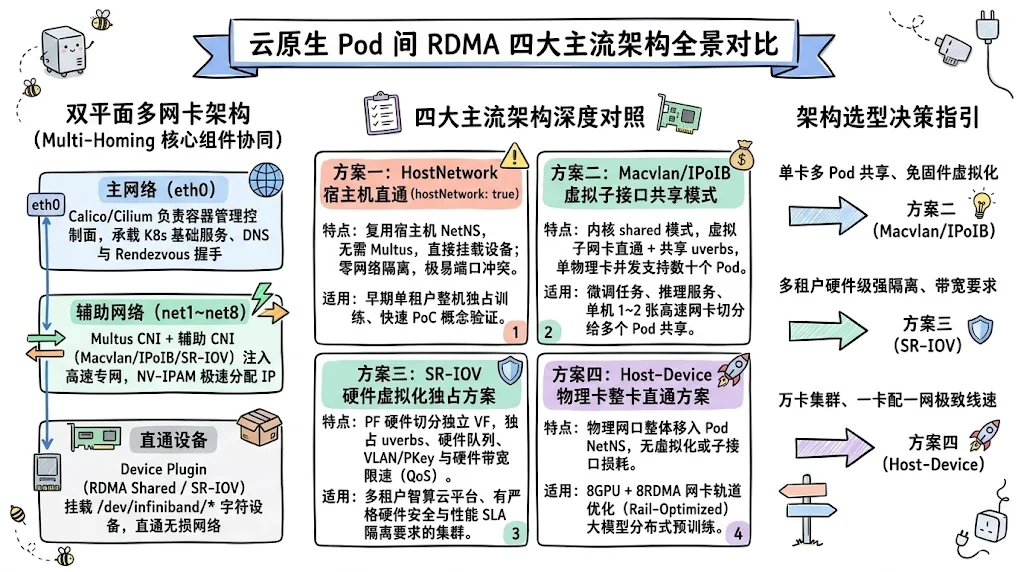
打通了底层驱动与内核命名空间模式后,我们来到云原生架构设计中最核心的一环:如何让处于隔离沙箱中的Pod既能正常接入Kubernetes集群的业务管理网络,又能同时打通前文所述的“控制寻址通道(网络接口netdev)”与“直通数据通道(字符设备/dev/infiniband/*)”?
为什么云原生RDMA普遍采用“双平面多网卡”架构
在生产级智算集群中,几乎所有服务器都配备了两套物理上完全独立的网络:一套是千兆或万兆的通用管理/存储以太网,另一套是100Gbps/200Gbps/400Gbps的高速参数交换网络(InfiniBand或RoCEv2专网)。
与之对应,运行在Kubernetes中的AI训练或推理Pod也需要同时接入这两套网络,这就催生了云原生高性能计算的事实标准——基于Multus CNI与Device Plugin的双平面多网卡(Multi-Homing)架构:
如果对默认Pod网络为什么带不动训练流量,以及Flannel、Calico、Cilium和几类高性能方案如何取舍感兴趣,想再看细一些,可以查看我之前的文章:云原生 Kubernetes 大模型训练集群 CNI 组件选型调研。
在这套双平面架构中,四大核心云原生组件各司其职,缺一不可:
- 默认主网络插件(
Calico/Cilium/Flannel)——负责eth0管理平面: 为Pod创建默认虚拟网卡eth0并保留默认路由,承载健康检查探针、CoreDNS解析、监控指标抓取以及分布式训练初始会合(Rendezvous)流量,避免管理流量干扰高速训练专网。 - 多网络编排元插件(
Multus CNI)——负责注入高速辅助网卡: 作为编排插件(Meta-Plugin),在默认CNI创建完eth0后,根据Pod的k8s.v1.cni.cncf.io/networks注解查找对应的NetworkAttachmentDefinition(NAD),调用辅助CNI插件(Macvlan、IPoIB、SR-IOV或Host-Device)将关联物理RDMA的接口net1(多卡节点常为net1~net8)注入Pod网络命名空间。 - 高性能专网地址管理插件(
NV-IPAM或Whereabouts)——负责分配RDMA网段IP: 为Pod内的net1分配独立专网IP以生成硬件GID并完成建连握手。大规模集群推荐使用NVIDIA开源的NV-IPAM,它通过“控制器按节点预分块+本机无锁分配”机制替代传统Whereabouts的分布式锁,支持高并发秒级分配与多轨道(Multi-Rail)子网规划。 - 硬件设备插件(
Device Plugin与CDI)——负责上报配额与挂载/dev/infiniband/*: 弥补CNI插件无法操作容器设备白名单的边界。通过节点上的k8s-rdma-shared-dev-plugin或sriov-network-device-plugin向kubelet上报RDMA可调度资源(如rdma/rdma_shared_device_a),并在容器启动时将对应的/dev/infiniband/uverbsX和rdma_cm安全注入容器。
如果对Device Plugin向kubelet注册、ListAndWatch与Allocate的机制感兴趣,想再看细一些,可以查看我之前的文章:Kubernetes Device Plugin。
四大云原生Pod间RDMA通信方案深度拆解
明确了组件分工后,在实际搭建集群时,辅助CNI插件与Device Plugin究竟该如何组合?根据业务对多租户隔离强度、单卡多Pod共享能力以及硬件SR-IOV依赖程度的不同需求,业界演进出了四种主流实现方案。下面按由共享到独占的架构演进顺序逐一剖析。
如果对Multus、SR-IOV Network Device Plugin、SR-IOV CNI、地址分配,以及共享HCA与独占VF的对比感兴趣,想再看细一些,可以查看我之前的文章:云原生Kubernetes训练集群Multus、SR-IOV与RDMA技术方案。
方案一:宿主机网络直通方案(HostNetwork与RDMA Shared Device Plugin)
这是最简单、最原始的过渡方案。在Pod的声明配置中直接开启hostNetwork: true,此时Pod不再创建独立的网络命名空间,而是直接复用宿主机的根网络命名空间(Host NetNS)。
- 工作机制:因为直接处于宿主机网络命名空间中,
Pod内天生就能看到宿主机上的所有物理RoCE网卡(如ens1f0)或InfiniBand网卡(如ib0),完全不需要Multus CNI和IPAM插件参与。只需部署k8s-rdma-shared-dev-plugin(或粗暴开启privileged: true特权模式),将/dev/infiniband/*字符设备挂载进容器,Pod就能以宿主机物理网卡的IP地址发起RDMA通信。 - 适用场景与致命局限:该方案配置成本极低,在单租户独占整机(例如一个训练
Pod直接申请整台节点的全部8张GPU和8张RDMA网卡)的早期集群中较为常见。但它的弊端极其明显:完全丧失了容器网络隔离性,同一节点上如果调度两个属于不同任务的Pod极易发生端口冲突;同时Pod IP与宿主机IP混为一谈,破坏了Kubernetes的网络安全策略(NetworkPolicy)与服务治理体系。
方案二:基于共享模式的虚拟子接口方案(Macvlan/IPVLAN/IPoIB与RDMA Shared Device Plugin)
如果希望每个Pod拥有独立的网络命名空间和专属IP地址,同时允许同一台节点上的多个Pod共享同一张物理RDMA网卡(且不需要在主板BIOS和网卡固件中折腾复杂的SR-IOV硬件虚拟化),那么方案二就是目前云原生环境下性价比最高、应用最广泛的架构。
- 工作机制:
- 宿主机内核保持默认的
rdma system set netns shared共享模式。 - 针对
RoCEv2以太网环境:通过Multus调用Macvlan CNI(或IPVLAN L2)。Macvlan会在宿主机物理RoCE网口(如ens1f0)上派生出一个拥有独立MAC地址的轻量级虚拟子接口(net1),将其移入Pod的独立netns并赋予专属IP。由于Macvlan子接口在内核设备树中直接挂载于物理网卡ens1f0之下,内核roce_gid_mgmt模块会自动识别该子接口的IP与MAC,并在底层mlx5_0网卡的硬件GID表中为该Pod生成专属的RoCEv2 GID条目。 - 针对
InfiniBand环境:由于InfiniBand链路层没有以太网MAC地址概念,不能使用Macvlan,此时只需将辅助插件替换为IPoIB CNI(ipoib-cni)。它会在宿主机ib0接口上创建出IPoIB虚拟子接口并移入Pod netns,实现完全相同的共享效果。 - 与此同时,
RDMA Shared Device Plugin将宿主机的/dev/infiniband/uverbs0和rdma_cm同时挂载给这两个Pod。默认情况下,该插件会在单张网卡上虚拟出63个可分配资源配额(hcaHandles),最多允许63个Pod并发共享同一张物理RDMA网卡。
- 宿主机内核保持默认的
- 适用场景与优缺点:非常适合单机只有
1~2张高速网卡但需要运行多个微调/推理Pod、或者切分GPU(如MIG/单卡Pod)共享网络的场景。缺点在于多个Pod底层共享同一个硬件HCA上下文与uverbs设备,无法在网卡硬件层面限制单个Pod消耗的队列对(QP)数量或精确隔离硬件级QoS带宽。
方案三:基于硬件虚拟化的SR-IOV独占方案(SR-IOV CNI/IB-SRIOV CNI与SR-IOV Device Plugin)
在多租户公有云、智算云平台或对安全性与性能隔离有严苛要求的生产集群中,不同租户的Pod绝不能共享同一个/dev/infiniband/uverbs0字符设备。此时就需要启用网卡的硬件级虚拟化技术——SR-IOV(Single Root I/O Virtualization,单根I/O虚拟化)。
- 工作机制:
- 在服务器
BIOS中开启VT-d/AMD-Vi与SR-IOV支持后,通过网卡驱动或SR-IOV Network Operator将一张物理网卡(物理功能PF,如mlx5_0)在PCIe硬件层面切分成多个虚拟功能网卡(VF,Virtual Function)。 - 每个
VF在Linux内核看来都是一张拥有独立PCIe总线地址(如0000:3b:00.2)、独立网络接口(如ens1f0v0)以及 独立RDMA设备实例(如mlx5_2、对应/dev/infiniband/uverbs2) 的完整网卡。 - 当
Pod被调度到节点上时,SR-IOV Network Device Plugin从空闲池中挑出一个VF分配给该Pod,仅将该VF专属的/dev/infiniband/uverbs2挂载进容器;同时Multus调用SR-IOV CNI(RoCE场景)或IB-SRIOV CNI(InfiniBand场景),将该VF的网络接口直接移入Pod的netns。若宿主机开启了rdma system set netns exclusive独占模式,连同mlx5_2这个RDMA设备本身也会被彻底移入Pod命名空间,实现与宿主机及其他租户的100%物理级隔离。
- 在服务器
- 适用场景与优缺点:不仅性能逼近裸金属,而且支持在硬件层面为每个
Pod(VF)单独配置VLAN(RoCE场景)、PKey分区(IB场景)以及最小/最大带宽保证(QoS Rate Limiting),是多租户智算云的标配方案。其代价是需要维护BIOS与网卡固件的SR-IOV配置,且在结合GPUDirect RDMA时需要重点处理PCIe ACS与IOMMU透传配置。
方案四:物理网卡整卡直通与轨道优化方案(Host-Device CNI与Device Plugin)
在当前最主流的千卡/万卡大模型预训练集群中,单台计算节点普遍采用类似NVIDIA HGX H100/H200的 8 GPU + 8 RDMA NIC(一卡配一网)轨道优化(Rail-Optimized)架构。在这种场景下,一张物理400Gbps网卡本身就只服务于紧挨着它的那1张GPU,根本不需要用SR-IOV切分给多个Pod共享,但团队又不想使用破坏网络隔离的hostNetwork: true。
- 工作机制:此时可以采用
CNI官方标准插件中的Host-Device CNI(在NVIDIA Network Operator中对应HostDeviceNetwork CRD)配合sriov-network-device-plugin(将物理PF作为整卡资源上报)。当Pod启动时,Host-Device CNI会直接把宿主机上的物理网卡主接口(如ens1f0)连根拔起,整体移入Pod的网络命名空间中;当Pod销毁时,再自动将该物理网卡移回宿主机根命名空间。 - 适用场景与优缺点:既有独立
Pod NetNS的干净隔离,又彻底省去了SR-IOV虚拟化层或Macvlan子接口转发层,是整机8卡训练或按“1卡GPU+1张物理网卡”整数倍切分算力时的极致性能方案。注意一旦物理网卡被移入Pod,宿主机上基于该网口的监控脚本将暂时看不到该接口,直到Pod退出。
四大云原生RDMA网络架构全景对比
为了便于架构师在实际项目中按需选型,我们将上述四种方案的核心技术指标汇总对比如下:
| 评估维度 | 方案一:HostNetwork直通 | 方案二:Macvlan/IPoIB共享 | 方案三:SR-IOV硬件虚拟化 | 方案四:Host-Device整卡独占 |
|---|---|---|---|---|
Pod网络命名空间 | 与宿主机共享(无隔离) | 独立Pod NetNS | 独立Pod NetNS | 独立Pod NetNS |
内核RDMA模式 | shared | shared | exclusive(推荐)或shared | exclusive或shared |
辅助CNI插件 | 无需辅助CNI | macvlan、ipvlan或ipoib | sriov-cni或ib-sriov-cni | host-device |
设备插件(Device Plugin) | k8s-rdma-shared-dev-plugin | k8s-rdma-shared-dev-plugin | sriov-network-device-plugin | sriov-network-device-plugin |
单张物理网卡多Pod共享 | 支持(共享宿主机IP) | 支持(每个Pod独立IP) | 支持(每个Pod独占一个硬件VF) | 不支持(单Pod独占整张物理卡) |
硬件级安全与QoS隔离 | 无 | 弱(共享同一uverbs设备) | 极强(独立uverbs、VLAN/PKey、限速) | 极强(物理整卡独占) |
是否需要开启硬件SR-IOV | 否 | 否 | 是(需BIOS与固件开启VF) | 否 |
| 典型生产适用场景 | 早期单租户整机独占训练、快速概念验证(PoC) | 推理服务、微调任务、少网卡节点的多Pod共享集群 | 多租户智算云平台、需要严格安全隔离与带宽保障的集群 | 8GPU+8NIC轨道路由(Rail-Optimized)大规模分布式训练集群 |
协议差异深潜:RoCEv2与InfiniBand在Pod通信中的底层机制
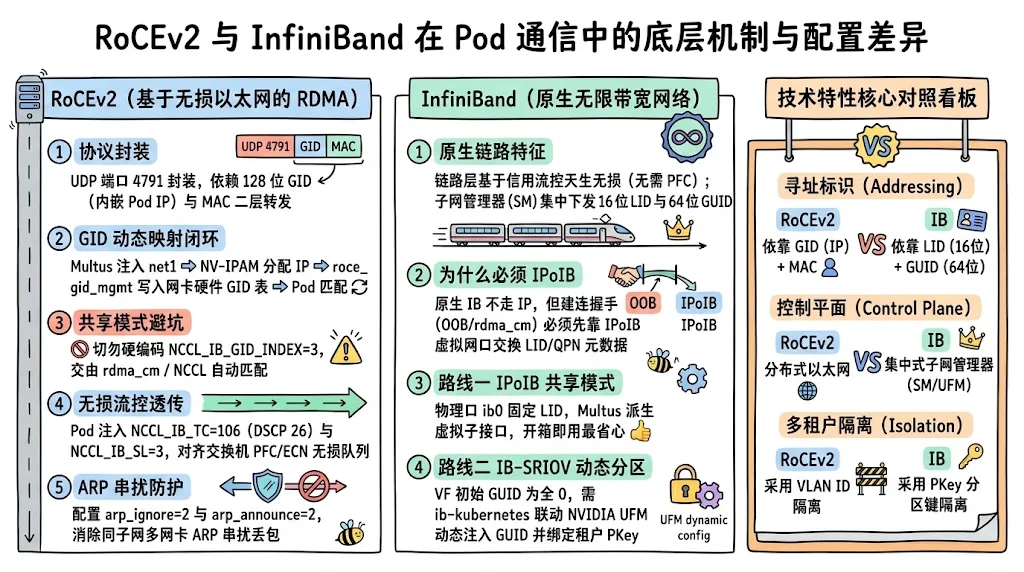
虽然在上层应用看来,无论是RoCEv2还是InfiniBand,容器里的NCCL或UCX调用的都是同一套libibverbs接口;但在底层链路层与控制平面上,RoCEv2构建于分布式以太网与UDP/IP之上,而InfiniBand构建于集中式子网管理器(SM)与原生IB链路层之上。这种基因差异导致两者在Kubernetes Pod通信时的寻址、隔离与调优细节截然不同。
如果对InfiniBand与RoCE在无损传输、拥塞控制和组网形态上的差别感兴趣,想再看细一些,可以查看我之前的文章:RDMA: InfiniBand vs RoCE。
RoCEv2在Pod间的通信链路与核心工程细节
从Pod IP到网卡硬件GID表的动态映射全流程
在前面讲“双通道模型”时我们提到,RoCEv2网卡硬件在发送数据包时,必须查阅内部的硬件GID(Global Identifier)表来填充UDP/IP和以太网MAC报文头。那么,在采用Macvlan或SR-IOV的云原生环境下,一个刚刚由Kubernetes动态分配给Pod的IP地址,究竟是如何一步步变成网卡硬件寄存器里的GID条目,并被容器内的NCCL准确选中的呢?
其底层完整闭环如下图所示:
理解了这条链路,我们就能立刻明白在Kubernetes下部署RoCEv2时最容易踩坑的三个核心工程细节:
- 共享模式下切勿硬编码
NCCL_IB_GID_INDEX=3: 裸机或独占模式(SR-IOV exclusive/Host-Device)下网卡拥有独立GID表,IPv4 RoCEv2 GID固定在Index 3。但在Macvlan多Pod共享网卡模式下,内核会在同一张物理网卡的硬件GID表中按Pod创建顺序动态追加条目(如Index 5、Index 7)。此时切勿硬编码NCCL_IB_GID_INDEX=3,应交由rdma_cm或NCCL根据当前Pod NetNS内的网卡自动匹配对应的RoCEv2 GID Index。 - 容器内无损流控优先级(
PFC/DSCP)透传:RoCEv2依赖无损以太网(PFC与ECN/DCQCN),且数据面绕过内核协议栈,宿主机tc/iptables打标对其无效。除在宿主机网卡配置Trust DSCP与cma_roce_tos外,还需在Pod内注入NCCL_IB_TC(如106,对应DSCP 26)和NCCL_IB_SL(如3)环境变量,让网卡硬件封装报文时直接打上匹配交换机无损队列的标签。 - 多网卡同子网下的
ARP串扰(ARP Flux)防护: 单节点存在多张同子网RoCE网卡或多个Macvlan接口时,Linux默认弱主机模型会导致跨网卡代答ARP,造成源MAC与GID错配并引发传输超时(transport retry counter exceeded)。需在宿主机及容器网络中配置sysctl参数:net.ipv4.conf.all.arp_ignore=2、net.ipv4.conf.all.arp_announce=2及net.ipv4.conf.all.rp_filter=0。
InfiniBand在Pod间的通信链路与分区隔离机制
与RoCEv2相比,原生InfiniBand(IB)网络有着完全不同的寻址与管理逻辑:它天然具备基于信用(Credit-Based)的链路层无损流控,不需要配置复杂的PFC/ECN;它的二层转发不看以太网MAC地址,而是看由集中式子网管理器(Subnet Manager,简称SM,如OpenSM或商业版NVIDIA UFM)统一分配的16位本地标识符(LID),设备的唯一身份标识则是64位的全局唯一标识符(GUID)。
那么,当我们将InfiniBand引入Kubernetes Pod时,需要重点解决哪两个核心问题?
为什么InfiniBand下的Pod仍然需要配置IPoIB分配IP地址
很多初次接触InfiniBand容器化的工程师都会困惑:“既然InfiniBand交换机是根据LID转发RDMA数据包的,根本不用IP协议,那为什么在Kubernetes里还要用ipoib-cni或ib-sriov-cni配合NV-IPAM给每个Pod的IB网口分配一个IP地址?”
原因就在于前文所述的 “通道一(建连握手)” :
- 当两个
Pod准备通过原生InfiniBand Verbs建立高速队列对(QP)连接之前,它们必须先通过一个可达的通信渠道交换彼此的LID、QP Number、GUID等元数据。 - 无论是
rdma_cm连接管理器,还是NCCL/UCX/MPI的带外引导(OOB Bootstrap),都是基于标准的IP地址来寻址对端并完成初始握手的。 IPoIB(IP over InfiniBand)正是Linux内核(ib_ipoib模块)提供的一层封装适配层:它在InfiniBand硬件端口之上虚拟出一个标准的Linux网络接口(如ib0),使得标准的TCP/IP协议能够跑在InfiniBand物理链路上。一旦双方Pod通过IPoIB接口的IP地址完成了毫秒级的建连握手,后续真正的大规模张量数据传输就会立刻切换到不经过IPoIB、不经过内核的纯原生InfiniBand RDMA Verbs通道,跑满400Gbps线速。
InfiniBand下的两种容器网络模式:IPoIB共享与IB-SRIOV动态分区
在Kubernetes集群中落地InfiniBand,同样对应着“共享”与“硬件虚拟化独占”两条技术路线,但其中的底层协同逻辑与RoCE有显著区别:
如上图所示,在选型InfiniBand方案时需特别注意以下核心事实:
- 路线一(
IPoIB CNI共享模式):在企业内部自建的大模型训练集群(单租户或内部多团队共享)中,最省心、最稳定的方式是使用ipoib-cni配合RDMA Shared Device Plugin(或整卡直通)。因为宿主机的物理IB端口(PF)在开机时就已经由交换机或节点上的OpenSM分配好了LID,ipoib-cni只需在宿主机ib0接口上创建虚拟子接口塞进Pod即可,完全不需要对子网管理器(SM)做任何动态接口改造。 - 路线二(
IB-SRIOV CNI多租户PKey隔离模式):如果要在InfiniBand网络上开启SR-IOV把VF分给不同租户的Pod,不能像以太网那样直接把VF塞进容器完事! 因为在InfiniBand规范中,新创建出来的SR-IOV VF默认节点与端口GUID全部是全零(00:00:00:00:00:00:00:00),为了安全,子网管理器(SM)会拒绝为全零GUID的VF分配LID,此时端口状态永远是PORT_DOWN或PORT_INITIALIZING。 因此,必须额外部署NVIDIA提供的ib-kubernetes控制器并与NVIDIA UFM(Unified Fabric Manager,企业级子网管理平台) 联动:当Pod启动时,ib-kubernetes自动从地址池中为该Pod抽取一个合法的64位GUID,由ib-sriov-cni写入VF,同时通过REST API通知UFM将该GUID加入租户指定的分区键(PKey,Partition Key,相当于InfiniBand硬件层的VLAN),唯有在同一PKey分区内的Pod才能在IB交换机层面互相通信。
RoCEv2与InfiniBand在云原生Pod环境下的全景对比
为了清晰展现两类网络在Kubernetes落地时的异同,我们将关键技术要素对照如下:
| 对比维度 | RoCEv2(基于无损以太网的RDMA) | InfiniBand(原生无限带宽网络) |
|---|---|---|
| 底层传输与寻址标识 | UDP/IP/Ethernet封装(端口4791);依靠128位GID(内嵌Pod IP)与二层MAC寻址 | 原生IB链路层与传输层封装;依靠子网管理器分配的16位LID与64位GUID寻址 |
Pod内网络接口的作用 | 既用于建连握手,又由内核roce_gid_mgmt将其IP/MAC直接映射为硬件RoCEv2 GID | 通过IPoIB协议提供TCP/IP连通性,用于OOB带外建连或rdma_cm握手交换LID/QPN |
共享模式辅助CNI插件 | Macvlan CNI或IPVLAN CNI(对应MacvlanNetwork CRD) | IPoIB CNI(对应IPoIBNetwork CRD) |
SR-IOV独占模式辅助CNI | SR-IOV CNI(对应SriovNetwork CRD) | IB-SRIOV CNI(对应SriovIBNetwork CRD) |
| 多租户网络硬件隔离机制 | 标准以太网VLAN ID隔离(在交换机与SR-IOV VF上直接打标) | InfiniBand PKey(分区键)隔离,需子网管理器(OpenSM/UFM)授权下发 |
| 外部控制面依赖 | 全分布式控制面(交换机运行BGP/PFC/ECN,无需中心控制器参与Pod生命周期) | 集中式控制面(强依赖子网管理器SM;若使用IB-SRIOV动态分区,还需部署ib-kubernetes对接UFM) |
| 容器与节点调优重心 | 必须确保GID Index正确匹配、容器内配置NCCL_IB_TC/SL对齐交换机无损队列、关闭ARP串扰 | 链路层天生基于信用流控无损传输,无需配置PFC/ECN,重心在于SM状态与IPoIB接口连通性 |
容器运行时与节点级调优:解锁内存锁页、CDI与拓扑亲和
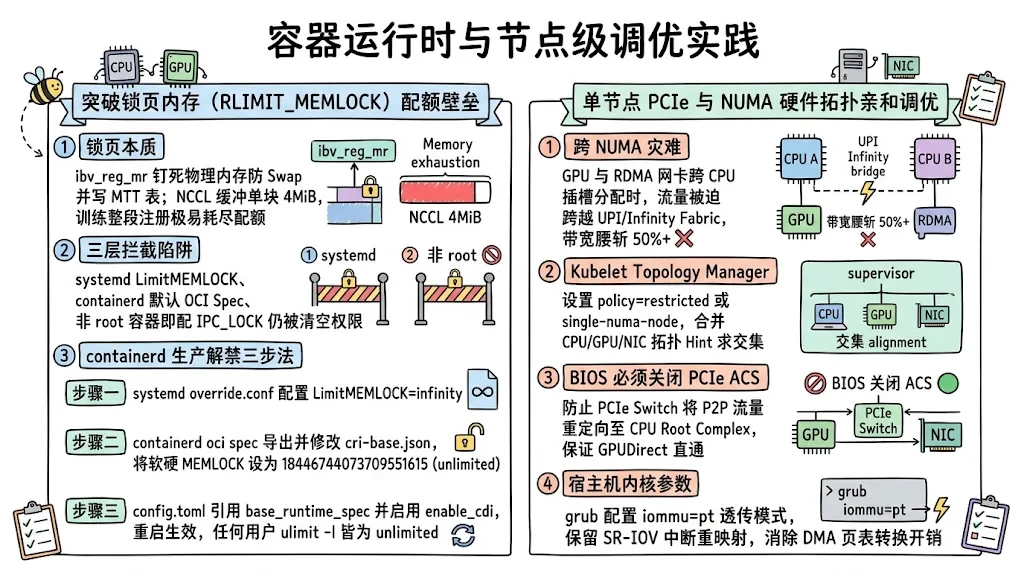
即便我们已经通过Multus CNI和Device Plugin把网络接口net1与字符设备/dev/infiniband/uverbsX双双送进了Pod,如果直接启动分布式训练容器,往往还会撞上最后两道隐蔽的关卡:
- 一是容器在调用
ibv_reg_mr()注册内存时直接报错Cannot allocate memory (ENOMEM)崩溃; - 二是虽然
RDMA能跑通,但跨机带宽只有理论值的一半不到。
这两类问题分别指向了容器运行时(containerd)的内存锁页限制与节点级的PCIe/NUMA硬件拓扑亲和配置。
突破锁页内存配额(RLIMIT_MEMLOCK)与权限壁垒
为什么容器内注册RDMA内存会报ENOMEM错误
如前文所述,RDMA网卡要绕过内核直接对应用内存或GPU显存执行DMA读写,必须先调用ibv_reg_mr()把这些页钉死(Pin/Lock)在物理页帧上,并把虚拟地址到物理页的映射写入网卡地址转换表(MTT)。普通TCP/IP发送时,内核会先把数据拷进已经常驻物理内存的套接字缓冲区(sk_buff),网卡DMA的是这块内核内存。RDMA数据面没有这次拷贝:门铃触发后,网卡按MTT中记录的物理地址直接读写,标准注册路径不处理缺页。页一旦被换出(Swap)或迁移,网卡仍会访问原来的物理页帧,读到无关数据或写坏其他内存。因此注册前必须锁页,容器里要提高的是RLIMIT_MEMLOCK允许锁住的字节数上限。
在Linux系统中,为了防止普通用户进程恶意锁死全部物理内存导致操作系统崩溃,内核通过进程资源限制参数 RLIMIT_MEMLOCK (在终端中可通过ulimit -l查看)严格限制单个进程允许锁定的最大物理内存字节数。
默认的64KB或8MB只覆盖普通进程锁住的少量页面。ibv_reg_mr()记入RLIMIT_MEMLOCK的是整块内存区域的长度,从注册成功一直占到ibv_dereg_mr(),不是单个报文的大小。队列和完成队列通常只有几十到几百KB,64KB至多完成一次很小的连通性测试。NCCL默认每块网络缓冲NCCL_BUFFSIZE为4MiB(4194304字节),单这一块就是64KB的64倍;通信器按通道和网卡为发送、接收各保留多块,两块4MiB就用尽8MB。用户缓冲注册(ncclCommRegister)或分离式推理把梯度、参数分片、KV Cache整段登记给网卡时,单块常见为数百MB到数GB,按显存池注册可以到数十GB。
在默认的Kubernetes与containerd环境中,存在着三层锁页内存拦截机制:
- 第一层(
systemd服务级限制):宿主机上的containerd.service守护进程默认受到systemd的限制,其LimitMEMLOCK通常仅为8MB(8192 KB)或64KB。 - 第二层(
OCI容器规范级限制):containerd在创建容器时生成的默认OCI Runtime Spec(config.json)会继承或设置较低的RLIMIT_MEMLOCK配额。注册上面这些网络缓冲或显存时,ibv_reg_mr()会立刻超过该配额并抛出ibv_reg_mr failed: Cannot allocate memory错误。 - 第三层(
CAP_IPC_LOCK权限与非root容器陷阱):许多教程会建议在Pod的securityContext.capabilities.add中添加IPC_LOCK能力(拥有CAP_IPC_LOCK特权的进程可以无视RLIMIT_MEMLOCK上限)。但这里有一个极易踩中的工程陷阱:在Linux内核的能力模型与Kubernetes实现中,securityContext.capabilities.add配置的权能 仅对以root用户(UID 0) 运行的容器进程生效!如果企业安全规范要求训练或推理容器以普通非root用户(例如runAsUser: 1000)启动,内核在执行execve时会清空非root进程的有效能力集(Effective Capabilities),导致IPC_LOCK形同虚设,容器内的ulimit -l依然被死死卡在64KB或8MB。
生产级containerd运行时配置方案(含RLIMIT_MEMLOCK与CDI支持)
为了彻底解决无论是root还是非root容器的锁页内存限制,并同时开启现代设备插件所需的 CDI(Container Device Interface,容器设备接口) 动态注入能力,最稳妥的生产实践是在宿主机containerd层面统一放开RLIMIT_MEMLOCK:
第一步:放开systemd中containerd服务的锁页限制
在宿主机上创建或修改/etc/systemd/system/containerd.service.d/override.conf:
[Service]
LimitMEMLOCK=infinity
第二步:生成并修改containerd的基础OCI运行时模板(base_runtime_spec)
使用containerd命令导出默认OCI规范文件,并将其中的RLIMIT_MEMLOCK软硬限制均设为无限制(在64位系统中用无符号64位整数最大值18446744073709551615表示RLIM_INFINITY):
# 导出默认 OCI 运行时规范模板
containerd oci spec > /etc/containerd/cri-base.json
编辑/etc/containerd/cri-base.json,确保在process.rlimits数组中包含如下RLIMIT_MEMLOCK配置:
{
  "ociVersion": "1.1.0",
  "process": {
    "rlimits": [
      {
        "type": "RLIMIT_NOFILE",
        "hard": 1048576,
        "soft": 1048576
      },
      {
        "type": "RLIMIT_MEMLOCK",
        "hard": 18446744073709551615,
        "soft": 18446744073709551615
      }
    ]
  }
}
第三步:在/etc/containerd/config.toml中引用基础模板并启用CDI
# 适用于 containerd 1.7.x(若为 containerd 2.x,插件路径为 io.containerd.cri.v1.runtime)
version = 2

[plugins."io.containerd.grpc.v1.cri"]
  # 启用 CDI(容器设备接口),支持 NVIDIA GPU Operator 与 RDMA 插件按标准规范注入设备
  enable_cdi = true
  cdi_spec_dirs = ["/etc/cdi", "/var/run/cdi"]

  [plugins."io.containerd.grpc.v1.cri".containerd.runtimes.runc]
    runtime_type = "io.containerd.runc.v2"
    # 指定使用包含无限制 RLIMIT_MEMLOCK 的基础 OCI 规范文件
    base_runtime_spec = "/etc/containerd/cri-base.json"
执行systemctl daemon-reload && systemctl restart containerd后,节点上所有新创建的Pod(无论是否使用root账号)在容器内执行ulimit -l均会显示为unlimited。此外,在Pod YAML中还要记得通过内存型emptyDir挂载/dev/shm(因为容器默认/dev/shm仅有64MB,会导致NCCL同节点卡间共享内存通信失败)。
单节点内PCIe与NUMA拓扑亲和配置
在解决了“能不能通”的问题后,接下来必须解决“能不能跑满线速”的问题。
如果对kubelet里Topology Manager、CPU Manager、Memory Manager的策略和配置感兴趣,想再看细一些,可以查看我之前的文章:Kubernetes CPU&NUMA亲和性调度。
在一台典型的8卡GPU服务器中,通常包含2颗CPU(对应NUMA Node 0和NUMA Node 1)以及多颗PCIe Switch芯片。每1张或2张GPU会与1张RDMA网卡挂载在同一颗PCIe Switch下,从而允许网卡与显存之间直接走PCIe P2P(点对点直通)完成GPUDirect RDMA。
如果Kubernetes在调度一个申请了“2张GPU与1张RDMA网卡”的Pod时,GPU Device Plugin分配了位于NUMA 0下的GPU 0和GPU 1,而RDMA Device Plugin却随手分配了一张位于NUMA 1下的网卡mlx5_6,会发生什么?此时网卡与GPU之间的每一字节数据都不得不跨越两颗CPU之间的内部互联总线(如Intel UPI或AMD Infinity Fabric),不仅PCIe P2P可能直接被芯片组阻断,跨机RDMA吞吐量更会直接腰斩!
为了让云原生节点上的Pod始终获得最优的GPUDirect RDMA硬件路径,需要在节点层面落实以下三项配置:
| 调优层级 | 关键配置项 | 推荐值与底层作用说明 |
|---|---|---|
kubelet拓扑管理器 | --topology-manager-policy--topology-manager-scope | 设置策略为restricted(或整块单NUMA任务设为single-numa-node),作用域设为pod,并开启CPU Manager的static策略。确保分配给同一个Pod的CPU、GPU和RDMA网卡严格位于同一NUMA节点下 |
主板BIOS设置 | PCIe ACS(访问控制服务) | 必须关闭(Disable ACS)。若开启ACS,PCIe Switch会强制把所有点对点(P2P)流量重定向到CPU Root Complex绕一圈,导致GPUDirect RDMA延迟飙升甚至完全失效 |
| 宿主机内核启动参数 | /etc/default/grub中的GRUB_CMDLINE_LINUX | 添加iommu=pt(Pass-Through透传模式)。既保留了SR-IOV所需的IOMMU中断重映射能力,又避免了每次RDMA DMA操作都触发高昂的IOMMU页表转换开销 |
生产级实战:基于NVIDIA Network Operator落地与验证
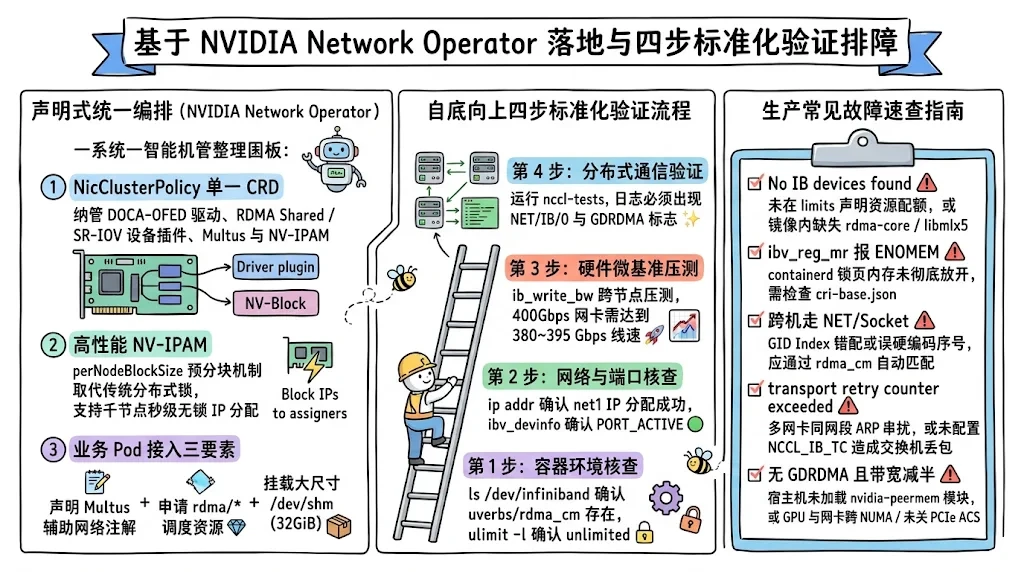
通过前面的层层剖析,我们已经看到:要在Kubernetes集群中实现生产级的Pod间RDMA通信,涉及到宿主机DOCA-OFED驱动、nvidia-peermem模块、Multus CNI、辅助CNI插件(Macvlan/IPoIB/SR-IOV/Host-Device)、NV-IPAM地址池管理以及RDMA/SR-IOV Device Plugin等十余个组件的协同安装与配置。
如果靠运维工程师在几百台节点上手工维护这些碎片化组件,极易出现版本冲突或配置漂移。为此,云原生社区与NVIDIA推出了统一做声明式生命周期管理的Operator——NVIDIA Network Operator,源码见 GitHub 仓库 Mellanox/network-operator。
NVIDIA Network Operator全局架构与核心CRD
与大家熟知的GPU Operator类似,NVIDIA Network Operator依托节点特征发现组件(NFD,自动识别带有feature.node.kubernetes.io/pci-15b3.present=true标签的Mellanox/NVIDIA网卡节点),只需要管理员提交一份名为 NicClusterPolicy 的核心自定义资源(CRD)以及对应的二层/三层网络定义,就能以DaemonSet容器化的方式全自动完成从底层驱动到上层插件的部署闭环:
下面我们给出可直接用于生产环境参考的完整配置链路。
第一步:编写NicClusterPolicy统一拉起驱动、插件与多网络底座
以下NicClusterPolicy配置展示了如何让Network Operator自动在节点上部署容器化DOCA-OFED驱动(自动开启nvidia-peermem)、Multus与标准辅助CNI插件包、NV-IPAM地址管理插件,以及分别按网卡名称暴露资源的RDMA Shared Device Plugin:
apiVersion: mellanox.com/v1alpha1
kind: NicClusterPolicy
metadata:
  name: nic-cluster-policy
spec:
  # 1. 容器化自动安装与管理宿主机 DOCA-OFED 驱动及 GPUDirect 桥接模块
  ofedDriver:
    image: doca-driver
    repository: nvcr.io/nvidia/mellanox
    version: doca3.5.0-26.07-0-ubuntu22.04
    livenessProbe:
      initialDelaySeconds: 30
      periodSeconds: 30
    readinessProbe:
      initialDelaySeconds: 10
      periodSeconds: 30

  # 2. 部署 RDMA 共享设备插件,将物理网卡暴露为 K8s 可调度资源
  rdmaSharedDevicePlugin:
    image: k8s-rdma-shared-dev-plugin
    repository: ghcr.io/mellanox
    version: v1.5.2
    config: |
      {
        "periodicUpdateInterval": 300,
        "configList": [
          {
            "resourceName": "rdma_shared_device_a",
            "rdmaHcaMax": 63,
            "selectors": {
              "vendors": ["15b3"],
              "ifNames": ["ens1f0", "ibs1f0"]
            }
          }
        ]
      }

  # 3. 部署高性能 NV-IPAM 插件,负责为 Pod 的 RDMA 网卡极速分配 IP
  nvIpam:
    image: kubernetes-ipam
    repository: ghcr.io/mellanox
    version: v0.3.4
    enableWebhook: false

  # 4. 部署 Multus 元网络插件以及包含 macvlan / ipoib / host-device 的 CNI 二进制包
  secondaryNetwork:
    cniPlugins:
      image: container-networking-plugins
      repository: ghcr.io/mellanox
      version: v1.5.0
    multus:
      image: multus-cni
      repository: ghcr.io/k8snetworkplumbingwg
      version: v4.1.0
    ipoib:
      image: ipoib-cni
      repository: ghcr.io/mellanox
      version: v1.2.0
多网卡轨道优化(
Rail-Optimized)扩展提示:如果节点配有8张高速网卡(例如eth1~eth8或ib0~ib7),只需在rdmaSharedDevicePlugin.config.configList(或sriovDevicePlugin)中定义rdma_shared_device_0至rdma_shared_device_7共8个独立资源项,分别绑定对应的单张物理网卡名即可。
第二步:按底层协议创建NV-IPAM地址池与辅助网络CRD
当NicClusterPolicy就绪后,我们首先创建一个由NV-IPAM管理的RDMA专网地址池(IPPool),然后根据集群物理交换机是 RoCEv2 还是 InfiniBand ,选择创建对应的网络自定义资源(Network Operator会自动将其翻译为Multus所需的NetworkAttachmentDefinition):
# 1. 定义 RDMA 高速专网 IP 地址池(每个节点预分配 32 个 IP,支持零锁竞争极速分配)
apiVersion: nv-ipam.nvidia.com/v1alpha1
kind: IPPool
metadata:
  name: rdma-fabric-pool
  namespace: nvidia-network-operator
spec:
  subnet: 192.168.100.0/18
  perNodeBlockSize: 32
  gateway: 192.168.100.1
接下来,根据物理网络类型二选一应用以下网络定义:
# 【场景 A:RoCEv2 以太网集群】创建 MacvlanNetwork(绑定宿主机 RoCE 物理口 ens1f0)
apiVersion: mellanox.com/v1alpha1
kind: MacvlanNetwork
metadata:
  name: roce-macvlan-net
spec:
  networkNamespace: "default"
  master: "ens1f0"
  mode: "bridge"
  mtu: 4200
  ipam: |
    {
      "type": "nv-ipam",
      "poolName": "rdma-fabric-pool"
    }
# 【场景 B:InfiniBand 集群】创建 IPoIBNetwork(绑定宿主机 IB 物理口 ibs1f0)
apiVersion: mellanox.com/v1alpha1
kind: IPoIBNetwork
metadata:
  name: ib-ipoib-net
spec:
  networkNamespace: "default"
  master: "ibs1f0"
  ipam: |
    {
      "type": "nv-ipam",
      "poolName": "rdma-fabric-pool"
    }
第三步:部署启用RDMA与GPUDirect的业务训练Pod
一切底层设施就绪后,容器要接上RDMA与GPUDirect,需要落实三件事:添加k8s.v1.cni.cncf.io/networks注解声明接入上面创建的辅助网络、在resources.limits中申请rdma/rdma_shared_device_a资源、配置大尺寸/dev/shm与NCCL环境变量。
生产级集群里,训练和推理任务通常交给Volcano这类调度器创建。调度器负责拉起一组Pod,并完成整组调度。下面的Pod YAML是简化的版本,仅用来说明原理。
apiVersion: v1
kind: Pod
metadata:
  name: llm-rdma-trainer-0
  namespace: default
  annotations:
    # 通知 Multus CNI 为 Pod 挂载名为 roce-macvlan-net(IB 环境则填 ib-ipoib-net)的辅助网卡,命名为 net1
    k8s.v1.cni.cncf.io/networks: |
      [
        {
          "name": "roce-macvlan-net",
          "interface": "net1"
        }
      ]
spec:
  containers:
    - name: pytorch-trainer
      image: nvcr.io/nvidia/pytorch:25.02-py3
      command: ["sleep", "infinity"]
      securityContext:
        capabilities:
          # 若以 root 运行,添加 IPC_LOCK 确保锁页权限;配合宿主机 containerd cri-base.json 兼容非 root
          add: ["IPC_LOCK"]
      env:
        - name: NCCL_DEBUG
          value: "INFO"
        # 显式启用 InfiniBand / RoCE Verbs 通信,禁止退化为纯 TCP
        - name: NCCL_IB_DISABLE
          value: "0"
        # 指定带外(OOB)握手使用辅助网卡 net1(或主网卡 eth0)
        - name: NCCL_SOCKET_IFNAME
          value: "net1"
        # 指定使用的 RDMA HCA 设备前缀
        - name: NCCL_IB_HCA
          value: "mlx5"
        # RoCEv2 场景下对齐交换机无损队列优先级(DSCP 26 -> TC 106,PFC Priority 3)
        - name: NCCL_IB_TC
          value: "106"
        - name: NCCL_IB_SL
          value: "3"
      resources:
        requests:
          nvidia.com/gpu: "1"
          rdma/rdma_shared_device_a: "1"
        limits:
          nvidia.com/gpu: "1"
          rdma/rdma_shared_device_a: "1"
      volumeMounts:
        - name: dshm
          mountPath: /dev/shm
  volumes:
    # 为 NCCL 提供充足的共享内存空间,避免容器默认 64MB /dev/shm 耗尽
    - name: dshm
      emptyDir:
        medium: Memory
        sizeLimit: 32Gi
Pod内RDMA连通性验证与常见故障排查手册
当两个测试Pod(例如分别调度在两台不同物理节点上的llm-rdma-trainer-0与llm-rdma-trainer-1)启动后,千万不要直接跑大模型训练脚本来“盲测”,而应当按照自底向上的四步验证法逐层确认每道关卡均已打通:
四步标准化验证流程
如果对ibv_devinfo字段、PCI地址以及InfiniBand/RoCE拓扑的查看方法感兴趣,想再看细一些,可以查看我之前的文章:RDMA硬件管理及网络拓扑信息查看。
# 【第 1 步】进入 Pod 容器,检查字符设备注入与锁页内存限制是否解除
kubectl exec -it llm-rdma-trainer-0 -- bash
ls -l /dev/infiniband/
# 预期输出:必须能看到 rdma_cm 以及 uverbs0(或对应 VF 的 uverbsX)
ulimit -l
# 预期输出:unlimited

# 【第 2 步】检查辅助网卡 net1 的 IP 以及 RDMA 硬件端口状态
ip -4 addr show dev net1
# 预期输出:成功获取到 192.168.100.x 网段的专属 IP
ibv_devinfo -d mlx5_0
# 预期输出:state 为 PORT_ACTIVE (4),link_layer 为 Ethernet(RoCE)或 InfiniBand

# 【第 3 步】使用 perftest 工具包执行跨节点 Pod 间 RDMA 硬件微基准压测
# 在 Pod 0(服务端,假设 net1 IP 为 192.168.100.11)中启动 RDMA Write 带宽测试(-R 表示使用 rdma_cm 自动建连并匹配 GID):
ib_write_bw -d mlx5_0 -R -F --report_gbits

# 在 Pod 1(客户端)中连接 Pod 0 的 net1 IP 发起压测:
ib_write_bw -d mlx5_0 -R -F --report_gbits 192.168.100.11
# 预期输出:400Gbps 网卡下 BW average 应接近 380~395 Gb/sec,证明纯硬件 RDMA 通道完全打通!
在第4步运行nccl-tests(如all_reduce_perf)或实际训练任务时,重点观察NCCL_DEBUG=INFO输出的初始化日志。只有看到类似如下带有 NET/IB 以及 GDRDMA 字样的日志,才标志着Pod间的RDMA与GPUDirect RDMA真正大功告成。
如果对nccl-tests的编译、参数和结果解读感兴趣,想再看细一些,可以查看我之前的文章:NVIDIA NCCL Tests:GPU通信性能与正确性测试实践。
NCCL INFO NET/IB : Using [0]mlx5_0:1/RoCE [RO]; OOB net1:192.168.100.11<0>
NCCL INFO Channel 00/02 : 0[0] -> 1[0] [receive] via NET/IB/0/GDRDMA
NCCL INFO Channel 00/02 : 0[0] -> 1[0] [send] via NET/IB/0/GDRDMA
云原生Pod间RDMA常见故障速查表
如果在上述验证过程中遇到异常,可对照下表快速定位根因:
| 故障现象或报错信息 | 底层根因剖析 | 工程解决措施 |
|---|---|---|
容器内执行ibv_devinfo提示No IB devices found | 一是Pod未申请rdma/*或nvidia.com/*扩展资源,未触发设备插件挂载/dev/infiniband/*;二是容器镜像内缺失用户态驱动库 libmlx5或rdma-core | 核查Pod的resources.limits是否声明了Device Plugin对应的资源名,并用ls /dev/infiniband确认设备存在;在镜像内安装ibverbs-providers与rdma-core |
报错ibv_reg_mr failed: Cannot allocate memory或ENOMEM | 容器进程的锁页内存配额(RLIMIT_MEMLOCK)不足(常见于非root容器即使加了IPC_LOCK仍受限于64KB/8MB) | 在宿主机containerd中配置LimitMEMLOCK=infinity并通过base_runtime_spec将默认RLIMIT_MEMLOCK设为无限制 |
NCCL未报错但跨机训练极慢,日志显示Using [0]eth0且走NET/Socket | 一是Pod内未能成功将mlx5_X的GID表与容器当前NetNS下的网络接口匹配上;二是误将 NCCL_IB_GID_INDEX硬编码成了错误的序号 | 检查Multus是否成功注入net1且其父接口与mlx5_X对应;移除硬编码的NCCL_IB_GID_INDEX(或通过rdma_cm自动匹配),设置NCCL_IB_DISABLE=0 |
RoCEv2下建连成功但收发大包卡死,报transport retry counter exceeded (synd 0x81) | 一是宿主机多网卡同网段发生ARP串扰,导致对端解析出错误的MAC/GID;二是容器未指定 NCCL_IB_TC,流量掉入交换机有损队列发生丢包;三是 Pod与交换机端口MTU不匹配 | 宿主机设置arp_ignore=2与arp_announce=2;根据交换机DSCP/PFC配置正确注入NCCL_IB_TC与NCCL_IB_SL;检查MacvlanNetwork的mtu与交换机一致 |
InfiniBand SR-IOV下容器内ibv_devinfo显示端口状态为PORT_DOWN | IB SR-IOV切分出的VF初始GUID全为0,未被子网管理器(SM/UFM)分配LID与PKey授权 | 若无需多租户硬件隔离,优先改用IPoIB CNI共享模式;若必须使用IB-SRIOV,需部署ib-kubernetes对接UFM或手动为宿主机VF配置非零GUID |
NCCL日志中出现NET/IB/0但没有GDRDMA后缀,且带宽减半 | GPUDirect RDMA未生效,数据经由宿主机CPU内存中转:宿主机未加载nvidia_peermem模块,或GPU与RDMA网卡跨了NUMA节点、开启了PCIe ACS | 宿主机执行modprobe nvidia_peermem;检查nvidia-smi topo -m确保分配的GPU与网卡同属一个NUMA/PIX域;在BIOS中关闭ACS并设置内核iommu=pt |
总结
在云原生Kubernetes集群下打通Pod间的RDMA高速通信,本质上是在 “容器沙箱的安全隔离” 与 “硬件卸载的直通诉求” 之间做一场精密的外科手术。回顾全文,只要抓住了以下五条核心主线,整套看似庞杂的技术栈便能一目了然:
- 看懂双通道模型:任何一次
RDMA通信都同时依赖“控制寻址通道(Linux网络接口netdev与IP/GID映射)”和“直通数据通道(/dev/infiniband/*字符设备与用户态硬件寄存器映射)”。 - 对齐分离式驱动:宿主机内核态(
mlx5_core/mlx5_ib及nvidia-peermem/DMA-BUF)与容器镜像内的用户态库(rdma-core/libmlx5)共同组成完整驱动链,并由内核rdma system netns的shared(共享)或exclusive(独占)模式决定多Pod隔离边界。 - 构建双平面网络:借助
Multus CNI保留eth0负责云原生控制管理面,同时按场景从**Macvlan/IPoIB共享模式**(轻量灵活,单卡多Pod共享)、SR-IOV硬件虚拟化模式(多租户硬件级强隔离)或**Host-Device整卡直通模式**(8GPU+8NIC轨道优化极致性能)中选择合适的辅助网络与Device Plugin组合。 - 区分
RoCEv2与IB基因:RoCEv2的核心在于内核roce_gid_mgmt的Pod IP→GID自动映射、无损队列优先级(DSCP/PFC)透传与ARP防串扰;InfiniBand的核心则在于通过IPoIB完成握手以及与子网管理器(SM/UFM)协同完成LID与PKey分区管理。 - 压实容器运行时与拓扑:通过
containerd的base_runtime_spec彻底解除RLIMIT_MEMLOCK锁页内存桎梏,并借助kubelet Topology Manager将CPU、GPU与RDMA网卡锁定在同一NUMA与PCIe Switch域内,方能释放GPUDirect RDMA的线速潜能。
参考资料
- NVIDIA Network Operator Official Documentation
- Mellanox k8s-rdma-shared-dev-plugin GitHub Repository
- Mellanox ib-kubernetes & InfiniBand SR-IOV CNI Architecture
- NVIDIA GPUDirect RDMA & DMA-BUF Kernel Documentation
- NCCL Environment Variables Official Reference
- Linux Kernel RDMA Subsystem & Network Namespace Isolation (
rdma-system)